


Il malware usa la memoria?
Solo in memoria: malware senza fila – un TTP sfuggente
Se Legacy AV, Whitelisting, Sandboxing e persino metodi di apprendimento automatico non possono proteggere dagli attacchi senza fila, cosa’s a sinistra? Le organizzazioni possono proteggersi adottando un approccio integrato che combina più metodi.
Riepilogo:
Il malware solo per la memoria, noto anche come malware senza fila, ha attirato l’attenzione a causa delle recenti violazioni dei dati come la rapina dei dati target. Questi tipi di programmi di malware si caricano nella RAM e non si installano sul disco rigido, rendendoli difficili da rilevare. Tuttavia, ci sono diversi motivi per cui il malware solo per la memoria non dovrebbe essere una delle maggiori preoccupazioni.
Punti chiave:
- La maggior parte del malware solo per la memoria non può persistere attraverso un riavvio, rendendo più facile la pulizia.
- I programmi antimalware sono più efficienti nella memoria di scansione rispetto alla scansione di un disco rigido o SSD.
- Non ci sono prove che suggeriscono che il malware solo per la memoria è più difficile da rilevare rispetto ad altri tipi di malware.
- Il malware solo per la memoria è in circolazione da molto tempo e i programmi antimalware possono facilmente rilevarli.
Domande:
- Quali sono i punti chiave per quanto riguarda il malware solo per la memoria?
I punti chiave per quanto riguarda il malware solo per la memoria sono che la maggior parte del malware solo per la memoria non può sopravvivere a un riavvio, i programmi antimalware non hanno difficoltà a scansionare la memoria, non ci sono prove che suggeriscono che il malware solo per la memoria è più difficile da rilevare e il malware solo per la memoria è in circolazione da molto tempo. - Perché è più facile pulire il malware solo per la memoria?
Il malware solo per memoria può essere facilmente ripulito riavviando il computer poiché non persiste attraverso un riavvio. - Perché i programmi antimalware sono più efficienti nella memoria di scansione?
La memoria di scansione è molto più veloce della scansione di un disco rigido o SSD e c’è meno RAM da scansionare rispetto allo spazio del disco. - Esistono prove che suggeriscono che il malware solo per la memoria è più difficile da rilevare?
No, non ci sono prove che suggeriscono che il malware solo per la memoria è più difficile da rilevare. I programmi antimalware possono facilmente rilevare malware solo per memoria. - Il malware solo per la memoria è in circolazione da molto tempo?
Sì, il malware solo per la memoria è in circolazione da molto tempo. Il worm SQL Slammer nel 2003 è un esempio di malware solo per memoria. - Quali sono i vantaggi del malware solo per la memoria?
I vantaggi del malware solo per la memoria includono una pulizia più semplice attraverso il riavvio, una scansione più rapida da parte di programmi antimalware e nessuna prova che suggerisce una maggiore difficoltà nel rilevamento. - Quali sono alcune idee sbagliate comuni sul malware solo per memoria?
Alcune idee sbagliate comuni sul malware solo per la memoria sono che è più difficile da rilevare e più pericolosi di altri tipi di malware. - In che modo il malware solo per la memoria si confronta con altri tipi di malware?
Il malware solo per memoria non è intrinsecamente più pericoloso o più difficile da rilevare rispetto ad altri tipi di malware. - Ci sono studi sul rilevamento di malware solo per memoria?
Non ci sono stati studi che indicano che il malware solo per la memoria è più difficile da rilevare o ha aumentato i falsi negativi. - Perché le organizzazioni non dovrebbero preoccuparsi del malware solo per la memoria?
Le organizzazioni non dovrebbero preoccuparsi del malware solo per la memoria perché possono essere facilmente ripulite, i programmi antimalware possono rilevarlo in modo efficiente e non ci sono prove che suggeriscono una maggiore difficoltà nel rilevamento.
Risposte:
- Il malware solo per la memoria può essere riassunto dai seguenti punti chiave: la maggior parte del malware solo per la memoria non può sopravvivere a un riavvio, i programmi antimalware sono efficienti nella memoria di scansione, non ci sono prove che suggeriscono una maggiore difficoltà nel rilevamento e il malware solo per la memoria è in circolazione da molto tempo. Questi punti chiave forniscono rassicurazioni sul fatto che il malware solo per la memoria non dovrebbe essere una delle maggiori preoccupazioni.
- Il malware solo per la memoria è più facile da ripulire perché non può persistere attraverso un riavvio. Chiudendo il punto di ingresso iniziale e riavviando il computer, il malware solo per memoria viene effettivamente rimosso senza la necessità di ricerche e pulizia approfondite.
- I programmi antimalware sono più efficienti nella memoria di scansione rispetto alla scansione di un disco rigido o SSD. La memoria di scansione è significativamente più veloce e richiede un minor numero di risorse, consentendo ai programmi antimalware di rilevare e rimuovere rapidamente il malware solo per memoria.
- Non ci sono prove che suggeriscono che il malware solo per la memoria è più difficile da rilevare rispetto ad altri tipi di malware. I programmi antimalware rilevano prontamente malware solo per memoria e non ci sono stati studi che indicano una maggiore difficoltà nel rilevamento o falsi negativi più elevati.
- Il malware solo per la memoria è in circolazione da molto tempo, con esempi come SQL Slammer Worm nel 2003. Nonostante la sua diffusione rapida e il potenziale impatto, il malware solo per la memoria è prontamente rilevabile dai programmi antimalware.
- I vantaggi del malware solo per la memoria includono una pulizia più semplice attraverso il riavvio. Poiché il malware solo per la memoria non può persistere attraverso un riavvio, semplicemente il riavvio del computer cancella eventuali tracce del malware, eliminando la necessità di procedure di pulizia complesse.
- Alcune idee sbagliate comuni sul malware solo per la memoria sono che è più difficile da rilevare e più pericolosi di altri tipi di malware. Tuttavia, i programmi antimalware non hanno difficoltà a rilevare malware solo per memoria e non ci sono prove a supporto del pericolo elevato rispetto ad altri tipi di malware.
- Il malware solo per memoria non è intrinsecamente più pericoloso o più difficile da rilevare rispetto ad altri tipi di malware. Mentre offre alcuni vantaggi per gli aggressori, come eludere determinati metodi di rilevamento, i programmi antimalware sono attrezzati per identificare e rimuovere efficacemente il malware di memoria.
- Non ci sono stati studi che indicano che il malware solo per la memoria è più difficile da rilevare o ha aumentato i falsi negativi. I programmi antimalware possono rilevare in modo affidabile malware solo per memoria e non ci sono prove che suggeriscono che gli attuali metodi di rilevamento sono insufficienti.
- Le organizzazioni non dovrebbero preoccuparsi del malware solo per la memoria perché possono essere facilmente ripulite, i programmi antimalware sono efficienti nel rilevarlo e non ci sono prove che suggeriscono una maggiore difficoltà nel rilevamento. Adottando un approccio integrato che combina più metodi di sicurezza, le organizzazioni possono effettivamente proteggere dal malware solo per la memoria.
Questa storia, “Dovresti preoccuparti del malware solo per la memoria?,”è stato originariamente pubblicato su Infoworld.com. Continua sugli ultimi sviluppi nella sicurezza della rete e leggi di più sul blog di consulente per la sicurezza di Roger Grimes su Infoworld.com. Per le ultime notizie sulla tecnologia aziendale, segui Inforld.com su Twitter.
Solo in memoria: malware senza fila – un TTP sfuggente
L’utilizzo di malware senza fila e di vivere al largo delle tecniche Land (LOTL) degli attori delle minacce informatiche (CTA) è aumentato nel corso degli anni. I dati dagli strumenti endpoint di WatchGuard indicano che circa l’80 % degli attacchi senza fila o LOTL nel 2020 sono già stati rilevati entro la fine del 2021. I dati di Symantec mostrano anche un aumento significativo dell’uso malizioso di CTAS di strumenti legittimi dal 2019 al 2020. L’indagine del Ponemon Institute sui professionisti IT responsabile della gestione dei rischi endpoint conferma ulteriormente le crescenti istanze di utilizzo di malware e LOTL senza file in ambienti aziendali.
Riferimenti:
Figura 1: Dati dal 2019-2020 raffiguranti l’uso dannoso di strumenti legittimi. (Fonte: Symantec)
Editorialista della sicurezza dal 2005, Roger Grimes detiene più di 40 certificazioni per computer e ha scritto dieci libri sulla sicurezza dei computer.
Diritto d’autore © 2014 IDG Communications, Inc.
Solo in memoria: malware senza fila – un TTP sfuggente
Se Legacy AV, Whitelisting, Sandboxing e persino metodi di apprendimento automatico non possono proteggere dagli attacchi senza fila, cosa’s a sinistra? Le organizzazioni possono proteggersi adottando un approccio integrato che combina più metodi.
Se ti preoccupi del malware solo per la memoria?
La recente rapina di dati target di oltre 40 milioni di record di carte di credito si preoccupa dell’impatto del malware solo per la memoria. Il malware target, una variante di Blackpos, fa parte di una famiglia di cavalli di Troia conosciuta come Trojan.Posram. Dopo lo sfruttamento iniziale, questi programmi si caricano semplicemente nella RAM: non si installano sul disco rigido.
La mancanza di “impronta software” rende sfuggenti programmi di malware per soli RAM. Alcune persone dicono che sono veramente temuti. Dovremmo preoccuparci di loro più di altri programmi di malware?
[Anche su Infoworld: 13 domande difficili sulla sicurezza dei computer. | Tieniti al passo con i principali problemi di sicurezza con la newsletter di sicurezza di Infoworld. “
Il panico per i trojan solo per la memoria mi ricorda tutte le profezie del giorno del giudizio sul malware rootkit, che potrebbe “nascondersi facilmente dai programmi antivirus.”Mi fa venire in mente l’isteria su worm bot robing, virus per allegati e -mail, virus di avvio e dirottatori DNS. All’inizio quei tipi di malware appena scoperti sembravano spaventosi, ma i programmi antimalware ora li rilevano prontamente tutti. L’unica sfida per il software antimalware è stare al passo con il numero assoluto di nuovi programmi di malware che appaiono ogni giorno. Rilevare un intero tipo di malware raramente è stato un problema.
In effetti, il malware solo per la memoria è una specie di benedizione, per alcuni motivi.
Innanzitutto, la maggior parte dei malware solo per la memoria non può vivere un riavvio. È vero, se non hai risolto ciò che gli ha permesso di ottenere l’accesso iniziale in primo luogo, il malware tornerà. Ma quanto è bello che se si chiude il foro di entrata iniziale, un semplice riavvio ripulirà il pasticcio di malware? Non c’è caccia al disco rigido che cerca di trovare tutti i luoghi che ha modificato o in cui può nascondersi, non tirano virus fuori dagli esecutibili ospiti e cercando di decidere come rimettere insieme Humpty-Dumpty, non c’è da chiederti. Basta riavviare il computer e rilassarsi. Mi sto immaginando su una spiaggia in Messico, a rilassarmi con una birra dorata.
In secondo luogo, i programmi antimalware adorano scansionare la memoria per i cattivi attori. Sono gli oggetti non memory che li rallentano. La memoria di scansione può essere letteralmente migliaia di volte più veloce della scansione di un disco rigido: è anche molto, molto più velocemente della scansione di un SSD. Inoltre, ovviamente, c’è molto meno RAM del disco da scansionare. Gli scanner antimalware adorerebbero attenersi alla memoria se potessero; Il successo delle prestazioni evaporrebbe.
In terzo luogo, non ho visto studi che affermano che il malware solo per la memoria è più difficile da rilevare o ha subito un aumento dei falsi negativi. Questo è ciò di cui la maggior parte delle persone è preoccupata; Non ho ancora visto prove reali.
Infine, sebbene Blackpos esista da solo pochi anni, abbiamo malware solo per memoria da molto tempo. Il worm SQL Slammer del 2003, per esempio, era solo a memoria. Fino ad oggi, SQL Slammer detiene ancora il titolo del verme più veloce. Ha sfruttato quasi tutti i server SQL senza patch su Internet in circa 10 minuti. Ma per quanto grave fosse, ho adorato la pulizia: hai patchate il server e riavviato. Ecco! La cosa cattiva è andata per sempre. Oh sì, è prontamente rilevato da ogni programma antivirus del mondo.
Quindi, no, non ho paura del malware solo per la memoria. Al contrario, mi attraversino le dita e spero che tutto il malware diventi solo memoria.
Questa storia, “Dovresti preoccuparti del malware solo per la memoria?,”è stato originariamente pubblicato su Infoworld.com. Continua sugli ultimi sviluppi nella sicurezza della rete e leggi di più sul blog di consulente per la sicurezza di Roger Grimes su Infoworld.com. Per le ultime notizie sulla tecnologia aziendale, segui Inforld.com su Twitter.
- Le 10 più potenti società di sicurezza informatica
- 7 Tendenze calde per la sicurezza informatica (e 2 diventando freddi)
- Le vulnerabilità Apache Log4j: una sequenza temporale
- Utilizzo del quadro NIST Cybersecurity per affrontare il rischio organizzativo
- 11 strumenti di test di penetrazione che i professionisti usano
- Sicurezza
- Sicurezza dei dati e delle informazioni
- Malware
Editorialista della sicurezza dal 2005, Roger Grimes detiene più di 40 certificazioni per computer e ha scritto dieci libri sulla sicurezza dei computer.
Copyright © 2014 IDG Communications, Inc.
Solo in memoria: malware senza fila – un TTP sfuggente
I dati del settore rivelano una crescita sostanziale degli attori della minaccia informatica (CTAS’) Utilizzo di malware senza fila e di vivere al largo delle tecniche Land (LOTL) negli ultimi anni.
- Alla fine del 2021, gli strumenti di endpoint di WatchGuard avevano “Già rilevato circa l’80 percento degli attacchi senza fila o vive fuori dagli attacchi di terra che [Hanno] visto per tutto il 2020.”
- In Figura 1, vediamo Symantec’I dati S dal 2019 e 2020 rivelano un notevole picco di CTAS’ Uso malizioso di strumenti legittimi durante quel periodo.
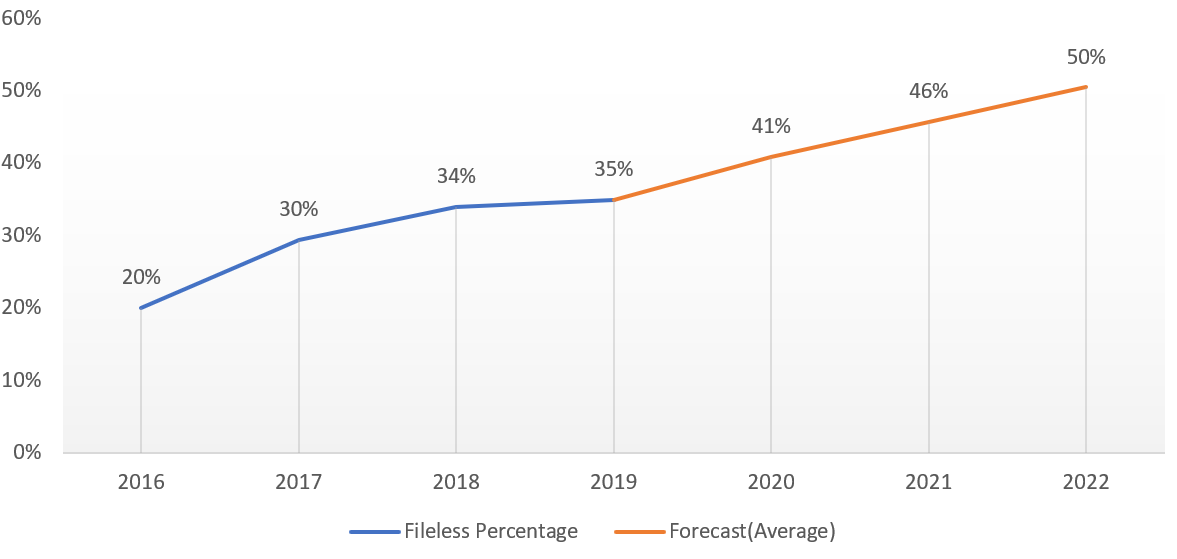
- La Figura 2 mostra come le istanze di malware senza fila e LOTL sono in aumento negli ambienti aziendali, come il Ponemon Institute ha appreso dal rilevamento dei professionisti IT responsabili della gestione del rischio endpoint.
Figura 1: dati dal 2019-2020 raffiguranti l’uso dannoso di strumenti legittimi. (Fonte: Symantec)
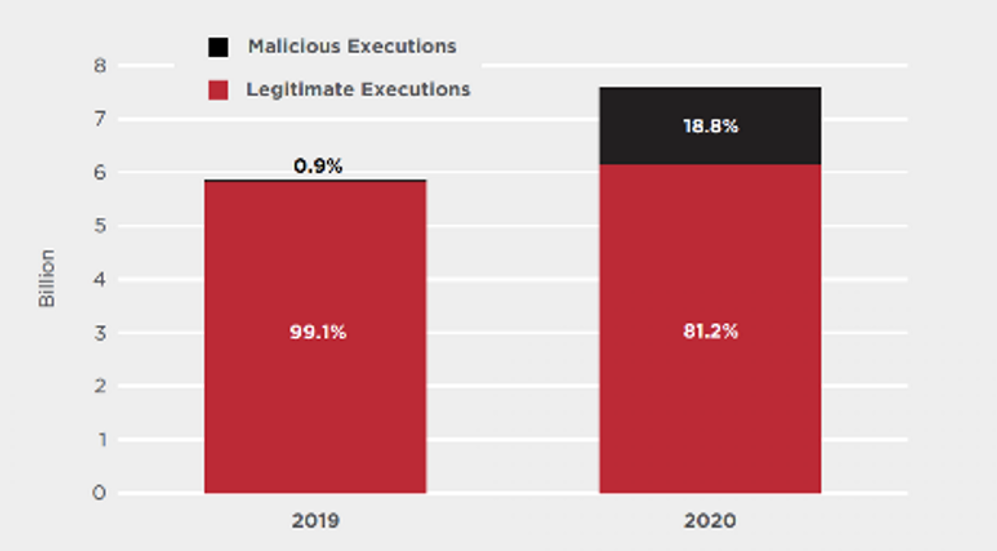
Figura 2: previsione basata sul Ponemon Institute’S Studio annuale 2020 sullo stato di sondaggio sui rischi per la sicurezza degli endpoint. (Fonte: Morphisec)
Cos’è il malware senza fila file?
Il malware senza file è un software dannoso che esegue in memoria, al contrario del malware tradizionale che scrive su disco utilizzando eseguibili dannosi. Dopo l’infezione, i CTA che distribuiscono malware senza file di solito sfruttano gli strumenti di sistema e amministratore legittimi come Windows PowerShell e Windows Management Instrumentation (WMI) per raggiungere la persistenza di LOTL. Una volta che i CTA stabiliscono un punto d’appoggio nella vittima’S Ambiente, possono quindi intensificare i privilegi e spostarsi lateralmente attraverso la rete (vedi Figura 3). Le varianti comuni di malware senza file includono Darkwatchman, Panda Stealer, Bitrat e Avemariat.
Figura 3: catena di attacco di malware senza file con esempi

Il malware senza file funziona in memoria e sfrutta gli strumenti affidabili, quindi appare spesso benigno agli antivirus basati sulla firma e ai sistemi di rilevamento delle intrusioni. Ciò gli consente di funzionare non rilevati, mantenere la persistenza e lasciare le organizzazioni delle vittime senza gli strumenti adeguati effettivamente ciechi a un’intrusione in corso. In effetti, organizzazioni’ Una forte dipendenza dagli strumenti basati sulla firma per difendere le proprie reti è probabilmente un driver significativo che motiva i CTA ad attaccare le reti con malware senza file.
Difendere contro malware senza fila
Secondo l’analisi del team di intelligence delle minacce cyber (CTI) presso il Centro di condivisione e analisi delle informazioni (MS-ISAC) multi-stato, i CTA continueranno a compromettere le organizzazioni a un ritmo crescente nonostante la più ampia dispiegamento di difesa organizzativa in profondità. In effetti, la loro valutazione suggerisce che il malware e il LOTL senza fila file saliranno al 50% degli attacchi totali contro gli ambienti aziendali nel 2022, abbinando così la frequenza degli attacchi basati su file per la prima volta. (Questa disparità potrebbe derivare dai CTA’ Malware senza fila file Utilizzare organizzazioni di spegnimento’ implementazioni difensive.)
Le organizzazioni si metteranno in una posizione significativamente migliore contro malware senza fila non aspettando di dare la priorità a quanto segue:
- Difesa-in-Depth: un’efficace difesa informatica contro il malware senza file sfruttare una strategia di difesa in profondità che i livelli di best practice e strumenti essenziali come firewall attivamente mantenuti, IDS/sistemi di prevenzione delle intrusioni, ESS, segmentazione della rete, rete e baseling di sistema, il principio del minimo privilegio, la gestione dei log, i requisiti di password forti e il patching tempestivo.
- CIS Endpoint Security Services (ESS): fornito dal Center for Internet Security (CIS), questo servizio analizza i dati endpoint per modelli sospetti, compresi quelli di malware senza file e tecniche LOTL. Quindi avvisa o blocca l’attività anomala a seconda della natura della minaccia.
- CIS Critical Security Controls (CIS Controls): un insieme prioritario e raccomandato di azioni per la difesa informatica, i controlli CSI forniscono modi specifici e attuabili per proteggere dagli attacchi più pervasivi e pericolosi
Altre importanti difese specifiche per il malware senza file prevedono l’occupazione di una combinazione di interfaccia di scansione antimalware (AMSI), monitoraggio del comportamento, scansione della memoria, limitare PowerShell a solo script firmati o limitare PowerShell e WMI a workstation specifiche, limitando le macro che consentono la macro abilitante per la macro che abilitano macro abilita.
Protezione aggiuntiva per SLTTS
Quando si tratta di combattere contro il malware senza file, u.S. Le enti governativi statali, locali, tribali e territoriali (SLTT) necessitano di tutto l’aiuto che possono ottenere. Fortunatamente, queste organizzazioni possono trovare un ampio supporto unendosi a MS-ISAC. Come membri, riceveranno l’accesso a regolari avvisi sulle minacce e briefing che esplorano il panorama delle minacce, tra cui l’evoluzione del malware senza fila. Si uniranno anche al nostro programma di condivisione degli indicatori che ingerisce/blocca gli indicatori dannosi in tempo reale. Questa intelligenza, così come le altre risorse di MS-ISAC, aiuterà SLTT a proteggersi da malware senza fila.
Malware senza fila Spiegato
Il malware senza file è un tipo di attività dannosa che utilizza strumenti nativi e legittimi integrati in un sistema per eseguire un attacco informatico. A differenza del malware tradizionale, il malware senza file non richiede a un utente malintenzionato di installare qualsiasi codice su un target’Sistema S, rendendo difficile rilevare.
Questa tecnica senza fila di utilizzo degli strumenti nativi per condurre un attacco dannoso viene talvolta definita vivere fuori dalla terra o lolbins
Tecniche di malware senza file
Mentre gli aggressori indossano’t Installare il codice per avviare un attacco di malware senza fila, devono comunque accedere all’ambiente in modo che possano modificare i suoi strumenti nativi per servire ai propri scopi. L’accesso e gli attacchi possono essere realizzati in diversi modi, ad esempio attraverso l’uso di:
- Kit di exploit
- Strumenti nativi dirottati
- Malware residente nel registro
- Malware solo per memoria
- Ransomware senza file
- Credenziali rubate
Kit di exploit
Gli exploit sono pezzi di codice, sequenze di comandi o raccolte di dati e i kit di exploit sono raccolte di exploit. Gli avversari usano questi strumenti per sfruttare le vulnerabilità che sono note per esistere in un sistema operativo o in un’applicazione installata.
Gli exploit sono un modo efficiente per lanciare un attacco di malware senza fila perché possono essere iniettati direttamente in memoria senza richiedere che nulla sia scritto su disco. Gli avversari possono usarli per automatizzare i compromessi iniziali su scala.
Un exploit inizia allo stesso modo, indipendentemente dal fatto che l’attacco sia senza fila o utilizza malware tradizionale. In genere, una vittima viene attirata tramite un’e -mail di phishing o ingegneria sociale. Il kit di exploit di solito include exploit per una serie di vulnerabilità e una console di gestione che l’attaccante può utilizzare per controllare il sistema. In alcuni casi, il kit di exploit includerà la possibilità di scansionare il sistema target per le vulnerabilità e quindi creare e lanciare un exploit personalizzato al volo.
Malware residente nel registro
Il malware residente del registro è malware che si installa nel registro di Windows per rimanere persistente mentre elude il rilevamento.
Comunemente, i sistemi Windows sono infettati attraverso l’uso di un programma di contagocce che scarica un file dannoso. Questo file dannoso rimane attivo sul sistema target, il che lo rende vulnerabile al rilevamento da parte del software antivirus. Il malware senza fila può anche utilizzare un programma di contagocce, ma non lo fa’t Scarica un file dannoso. Invece, il programma di contagocce stesso scrive codice dannoso direttamente nel registro di Windows.Il codice dannoso può essere programmato per il lancio ogni volta che viene lanciato il sistema operativo e non è possibile scoprire un file dannoso: il codice dannoso è nascosto in file nativi non soggetti a rilevamento AV.
La più antica variante di questo tipo di attacco è Poweliks, ma da allora sono emersi molti, tra cui Kovter e Gootkit. Il malware che modifica le chiavi del registro è molto probabile che rimanga sul luogo non rilevate per lunghi periodi di tempo.
Malware solo per memoria
Il malware solo per memoria risiede solo in memoria. Un esempio di malware solo per memoria è il worm Duqu, che può rimanere inosservato perché risiede esclusivamente nella memoria. Duqu 2.0 è disponibile in due versioni; Il primo è un backdoor che consente all’avversario di ottenere un punto d’appoggio in un’organizzazione. L’avversario può quindi utilizzare la versione avanzata di Duqu 2.0, che offre ulteriori funzionalità come ricognizione, movimento laterale e esfiltrazione di dati. Duqu 2.0 è stato utilizzato per violare con successo le aziende nel settore delle telecomunicazioni e almeno un noto fornitore di software di sicurezza.
Ransomware senza file
Gli avversari non si limitano a un tipo di attacco. Usano qualsiasi tecnologia che li aiuterà a catturare il loro payload. Oggi, gli aggressori di ransomware utilizzano tecniche senza fila per incorporare il codice dannoso nei documenti attraverso l’uso di linguaggi di script nativi come macros o per scrivere il codice dannoso direttamente in memoria attraverso l’uso di un exploit. Il ransomware quindi dirotta gli strumenti nativi come PowerShell per crittografare i file di ostaggio senza mai aver scritto una sola riga su disco.
Credenziali rubate
Gli aggressori possono iniziare un attacco senza fila attraverso l’uso di credenziali rubate in modo che possano accedere al loro obiettivo con il pretesto di un utente legittimo. Una volta dentro, l’attaccante può utilizzare strumenti nativi come Windows Management Instrumentation (WMI) o PowerShell per condurre il loro attacco. Possono stabilire la persistenza nascondendo il codice nel registro o nel kernel o creando account utente che garantiscono loro l’accesso a qualsiasi sistema che scelgono.
In che modo gli avversari usano attacchi senza fila per eludere la tua sicurezza
Scarica questo white paper per apprendere l’anatomia dettagliata di un’intrusione senza fila, incluso il compromesso iniziale, guadagnare comandi e controllo, crescere i privilegi e stabilire la persistenza.
Fase di un attacco senza fila
Per dimostrare come può funzionare un attacco senza fila, di seguito è un’infografica che illustra un’intrusione senza fila del mondo reale scoperto dal team di risposta agli incidenti di Crowdstrike (IR).
Fase n. 1: accedere
Tecnica: Sfruttare a distanza una vulnerabilità e utilizzare gli script Web per l’accesso remoto (EG. China Chopper)
L’attaccante ottiene l’accesso remoto alla vittima’Sistema S, per stabilire una spiaggia per il suo attacco.
Fase n. 2: rubare le credenziali
Tecnica: Sfruttare a distanza una vulnerabilità e utilizzare gli script Web per l’accesso remoto (EG. Mimikatz)
Usando l’accesso ottenuto nel passaggio precedente, l’attaccante ora cerca di ottenere credenziali per l’ambiente che ha compromesso, permettendogli di passare facilmente ad altri sistemi in quell’ambiente.
Fase n. 3: mantenere la persistenza
Tecnica: Modifica il registro per creare un backdoor (ad es. Bypass dei tasti appiccicosi)
Ora, l’attaccante crea una backdoor che gli permetterà di tornare in questo ambiente a piacimento, senza dover ripetere i passaggi iniziali dell’attacco.
Fase #4: Exfiltrate Data
Tecnica: Utilizza il file system e l’utilità di compressione integrata per raccogliere dati, quindi utilizza FTP per caricare i dati
Nel passaggio finale, l’attaccante raccoglie i dati che desidera e li prepara per l’esfiltrazione, copiandoli in una posizione e quindi comprimendolo utilizzando strumenti di sistema prontamente disponibili come compact. L’attaccante quindi rimuove i dati dalla vittima’S ambiente caricandolo tramite FTP.
Come rilevare malware senza file
Se Legacy AV, Whitelisting, Sandboxing e persino metodi di apprendimento automatico non possono proteggere dagli attacchi senza fila, cosa’s a sinistra? Le organizzazioni possono proteggersi adottando un approccio integrato che combina più metodi.
Affidati agli indicatori di attacco anziché agli indicatori di compromesso da solo
Gli indicatori di attacco (IOAS) sono un modo per adottare un approccio proattivo contro gli attacchi senza fila. Ioas non si concentrano sui passi di come viene eseguito un attacco – invece, cercano segni che un attacco può essere in corso.
IOAS includono segni come esecuzione del codice, movimenti laterali e azioni Sembra che sia destinato a sfogliare il loro vero intento.
IOAS non si concentrano su come vengono lanciati o eseguiti i passaggi. Non importa se l’azione è stata avviata da un file sul disco rigido o da una tecnica senza fila. L’unica cosa che conta è l’azione eseguita, il modo in cui si è riferito ad altre azioni, la sua posizione in una sequenza e le sue azioni dipendenti. Questi indicatori rivelano le vere intenzioni e gli obiettivi dietro i loro comportamenti e gli eventi che li circondano.
Poiché gli attacchi senza fila sfruttano i linguaggi di scripting legittimi come PowerShell e non vengono mai scritti sul disco stesso, non vengono rilevati da metodi, whitelisting e sandboxing basati sulla firma. Anche i metodi di apprendimento automatico non riescono ad analizzare malware senza fila. Ma IOAS cerca sequenze di eventi che persino il malware senza fila deve eseguire per raggiungere la sua missione.
E poiché IOAS esamina l’intento, il contesto e le sequenze, possono persino rilevare e bloccare le attività dannose che vengono eseguite utilizzando un account legittimo, il che è spesso in cui un utente malintenzionato usa le credenziali rubate.
Impiegare la caccia alle minacce gestite
La caccia alle minacce per il malware senza fila filmata richiede tempo e lavori laboriosi che richiedono la raccolta e la normalizzazione di ampie quantità di dati. Eppure è una componente necessaria in una difesa che protegge dagli attacchi senza fila e per questi motivi, l’approccio più pragmatico per la maggior parte delle organizzazioni è quello di trasformare le loro minacce a un fornitore di esperti.
I servizi di caccia alle minacce gestite sono in guardia tutto il giorno, alla ricerca in modo proattivo di intrusioni, monitorando l’ambiente e riconoscendo attività sottili che passerebbero inosservate dalle tecnologie di sicurezza standard.
Come crowdstrike può impedire attacchi senza fila nella tua organizzazione
Come abbiamo visto, le tecniche senza fila sono estremamente impegnative da rilevare se si fa affidamento su metodi basati su firma, sandboxing, whitelisting o persino metodi di protezione dell’apprendimento automatico.
Per proteggere da attacchi furtivi e senza fila, Crowdstrike combina in modo univoco più metodi in un approccio potente e integrato che offre una protezione endpoint senza rivali. La piattaforma Crowdstrike Falcon® offre protezione endpoint nativa cloud e di prossima generazione tramite un singolo agente leggero e offre una serie di metodi di prevenzione e rilevamento complementari:
- L’inventario delle applicazioni scopre tutte le applicazioni in esecuzione nel tuo ambiente, aiutando a trovare vulnerabilità in modo da poterli patchar o aggiornarle e possono’essere l’obiettivo dei kit di exploit.
- Bloccare Exploit arresta l’esecuzione di attacchi senza fila tramite exploit che sfruttano le vulnerabilità senza patch.
- Gli indicatori di attacco (IOAS) identificano e bloccano l’attività dannosa durante le prime fasi di un attacco, prima di poter eseguire completamente e infliggere danni. Questa capacità protegge anche da nuove categorie di ransomware che non utilizzano file per crittografare i sistemi delle vittime.
- Il controllo dello script fornisce visibilità e protezione ampliate contro gli attacchi basati su script di fileles.
- La scansione di memoria avanzata protegge da attacchi senza fila e malware come APT, ransomware e strumenti a doppio uso come Cobalt Strike in Memory.
- La caccia gestita cerca in modo proattivo tutto il tempo per attività dannose generate a seguito di tecniche senza fila.
Conosci l’autore
Kurt Baker è senior direttore del marketing del prodotto per Falcon Intelligence a Crowdstrike. Ha oltre 25 anni di esperienza in posizioni di leadership senior, specializzate in società di software emergenti. Ha esperienza in intelligence per minacce informatiche, analisi della sicurezza, gestione della sicurezza e protezione avanzata delle minacce. Prima di entrare a far parte di Crowdstrike, Baker ha lavorato in ruoli tecnici presso Tripwire e ha co-fondato startup in mercati che vanno dalle soluzioni di sicurezza aziendale ai dispositivi mobili. Ha conseguito una laurea in arti presso l’Università di Washington e ora ha sede a Boston, nel Massachusetts.
Un approccio di rilevamento di malware basato sull’apprendimento profondo e sulla memoria forense
QILU University of Technology (Shandong Academy of Sciences), Shandong Information Science Center (Na- 5 Tornal Supercomputer Center a Jinan), Shandong Provincial Key Laboratory of Computer Networks), Jinan 250014, Cina
Mathematical Institute, The Serbian Academy of Sciences and Arts, 11000 Belgrado, Serbia
Autore a cui dovrebbe essere affrontato la corrispondenza.
Simmetria 2023, 15(3), 758; https: // doi.org/10.3390/SYM15030758
Ricevuto: 28 dicembre 2022 / rivisto: 22 febbraio 2023 / Accettato: 17 marzo 2023 / Pubblicato: 19 marzo 2023
Astratto
Man mano che gli attacchi informatici diventano più complessi e sofisticati, nuovi tipi di malware diventano più pericolosi e difficili da rilevare. In particolare, il malware senza file inietta un codice dannoso nella memoria fisica direttamente senza lasciare tracce di attacco sui file del disco. Questo tipo di attacco è ben nascosto ed è difficile trovare il codice dannoso nei file statici. Per i processi dannosi in memoria, i metodi di rilevamento basati sulla firma stanno diventando sempre più inefficaci. Affronta queste sfide, questo documento propone un approccio di rilevamento di malware basato sulla rete neurale convoluzionale e la forense di memoria. Poiché il malware ha molte funzionalità simmetriche, il modello di allenamento salvato può rilevare un codice dannoso con funzionalità simmetriche. Il metodo include la raccolta di campioni statici maligni e benigni eseguibili, l’esecuzione dei campioni raccolti in una sandbox e la creazione di un set di dati di eseguibili portatili in memoria attraverso la memoria forense. Quando è in esecuzione un processo, non tutto il contenuto del programma viene caricato in memoria, quindi i frammenti binari vengono utilizzati per l’analisi del malware anziché per gli interi file eseguibili (PE). I frammenti di file PE sono selezionati con lunghezze e posizioni diverse. Abbiamo condotto diversi esperimenti sul set di dati prodotto per testare il nostro modello. Il file PE con 4096 byte di frammento di intestazione ha la massima precisione. Abbiamo raggiunto una precisione di previsione fino a 97.48%. Inoltre, un esempio di attacco senza fila è illustrato alla fine del documento. I risultati mostrano che il metodo proposto può rilevare efficacemente i codici dannosi, in particolare l’attacco senza fila. La sua precisione è migliore di quella dei comuni metodi di apprendimento automatico.
1. introduzione
Con lo sviluppo della tecnologia Internet, gli attacchi di malware sono diventati più diffusi e sofisticati. Attualmente, il malware è uno dei vettori di attacco dominanti utilizzati dai criminali informatici per svolgere attività dannose [1]. Ogni giorno, l’Istituto AV-Test registra oltre 450.000 nuovi programmi dannosi (malware) e applicazioni potenzialmente indesiderate (PUA) [2]. I prodotti antivirus implementano tecnologie di analisi statiche ed euristiche per rilevare malware. Sfortunatamente, questi approcci sono diventati meno efficaci per rilevare malware sofisticato che sfrutta le tecniche di offuscamento e crittografia [3]. In particolare, gli attacchi di malware senza fila sono usati selvaggiamente e causano gravi perdite. Il malware senza fila è un tipo di software dannoso che non si basa sui file e non lascia impronte sul disco del computer. È difficile rilevare programmi dannosi sconosciuti senza conoscere le loro firme.
Per combattere tali minacce, molte ricerche vengono condotte in vari campi, tra cui apprendimento profondo, forense della memoria, teoria dei numeri e così via [4,5,6]. Memory Forensics offre approfondimenti unici sullo stato interno del sistema di kernel e programmi di esecuzione [7]. La memoria ha un alto potenziale per contenere un codice dannoso da un’infezione, in tutto o in parte, anche se non viene mai scritta su disco, perché deve essere caricato in memoria da eseguire [8]. Il bersaglio dell’analisi della memoria forense è un dump di memoria da dove possono essere estratte le tracce di attacco. Al contrario, queste tracce non sono disponibili con il tradizionale metodo di analisi del disco. Durante l’analisi della memoria, i malware vengono eseguiti in una sandbox per impedire ai Malware di causare danni all’intero sistema informatico, che viene realizzato stabilendo macchine virtuali. I dati di memoria devono essere raccolti in modo tempestivo quando il malware è in esecuzione sulla macchina virtuale (VM). In questo documento, i dati di memoria vengono scaricati sul disco utilizzando l’algoritmo di dump di memoria per ulteriori analisi. Oltre a scaricare i dati di memoria, i file di eseguibili portatili dannosi (PE) devono essere estratti da migliaia di dati di memoria come dati di esempio. Bozkir et al. [9] ha presentato un approccio per riconoscere il malware catturando il dump di memoria di processi sospetti, che può essere rappresentato come un’immagine RGB. Tuttavia, la raccolta di dati di memoria dannosi in questo modo è inadeguato. Il processo estratto potenzialmente non ha caricato il codice dannoso in memoria. Alcuni processi dannosi vengono iniettati in nuovi processi per eseguire azioni dannose. In questo caso, l’estrazione di un singolo processo dannoso non può riflettere completamente il comportamento dannoso del processo. Solo l’estrazione di un singolo processo in esecuzione dannoso non può riflettere completamente il valore dell’analisi della memoria. Il set di dati in questo documento prende più dump di immagini di memoria ed estrae tutti i processi e i dati DLL. Con una stretta analisi di queste informazioni, i dati benigni e dannosi possono essere classificati tramite una piattaforma di rilevamento.
Questo documento propone un metodo di rilevamento del codice dannoso. È creato un modello di rete neurale per rilevare frammenti di campionamento. Il frammento del campione’Il costo del tempo è ridotto rispetto al rilevamento dell’intero campione. Per ridurre il problema della perdita di dati cruciali causata dal rilevamento dei frammenti di campione, selezioniamo frammenti rilevando posizioni e lunghezze diverse per determinare il luogo e le dimensioni appropriate dei segmenti rilevati.
I principali contributi di questo documento sono riassunti come segue:
Questo documento crea un set di dati di file eseguibile (PE) portatile in memoria, che estrae campioni di memoria più dannosi nel processo. Questo documento raccoglie per la prima volta file PE statici dalle note biblioteche di campioni dannose Virusshare e Malshare, che sono ampiamente utilizzate dai ricercatori e hanno un’alta persuasività. Quindi, questo documento scarica il software comune dalla piattaforma Microsoft ufficiale. Infine, esegue i campioni statici nell’esecuzione di macchine virtuali ed estrae i campioni dinamici per creare il nostro set di dati;
Costruiamo un modello basato sulla rete neurale (CNN) e utilizziamo il modello per formare segmenti di memoria per ottenere un rilevamento accurato di codice dannoso;
Diamo un esempio di attacco di malware senza file sul giornale. Poiché il set di dati di file dinamico è costruito, ha buone prestazioni di rilevamento per “nessun file” Attacchi e campioni dannosi che possono essere rilevati solo in file dinamici.
2. Lavoro correlato
2.1. Memory Forensics
Gli approcci forensi del computer sono divisi nell’analisi dinamica e statica. L’analisi statica è basata sulla premessa di non eseguire il programma. Include il processo di estrazione dei componenti, delle istruzioni, del flusso di controllo e della funzione delle funzioni di funzionalità di codice statico di sequenza, come il rilevamento di anomalie [10]. Jiang et al. [11] ha progettato una serie di schemi di verifica binaria di integrità a grana fine per verificare l’integrità dei file binari nelle macchine virtuali. Il metodo di analisi statica aveva un’alta copertura del campione. Tuttavia, è stata necessaria un’analisi a più angolo per rilevare il codice dannoso usando tecnologie come deformazione, polimorfismo, offuscamento del codice e crittografia [12]. Per quanto riguarda l’analisi dinamica, la maggior parte delle informazioni nella memoria era incompleta a causa del meccanismo di paging e sostituzione della memoria. Il programma non ha trasferito tutte le informazioni nella memoria durante l’esecuzione. Solo una parte delle informazioni è stata prima spostata nella memoria. Pertanto, non è possibile ottenere i dati eseguibili completi.
Inoltre, una volta che un programma dannoso rileva che lo strumento di rilevamento del virus/Trojan stava eseguendo o utilizzando software per ottenere la memoria, interrompe immediatamente il comportamento di attacco, autodistrutti e cancella le tracce di attacco. Questi comportamenti di autodistruzione propongono requisiti più elevati per il campionamento e il rilevamento dei dati di memoria. Otsuki et al. [13] ha proposto un metodo per estrarre tracce di stack dalle immagini di memoria in un sistema Windows a 64 bit. Hanno dimostrato l’efficacia del caricatore stealth analizzando una serie di eseguibili Windows e malware protetti con il caricatore stealth utilizzando i principali strumenti di analisi dinamica e statica. Uroz et al. [14] ha studiato le limitazioni che la forense di memoria impone al processo di verifica della firma digitale dei file firmati da PE di Windows ottenuti da un dump di memoria. Queste limitazioni sono incompletezza dei dati, modifiche ai dati causate da trasferimento, file firmati dal catalogo e incoerenze di file e processi eseguibili. Cheng et al. [15] ha proposto un algoritmo di clustering che ha realizzato il metodo di analisi della correlazione dei dati di memoria automatica attraverso l’analisi della struttura dei dati critici del sistema operativo. Le idee principali sono garantire l’accuratezza dei dati nell’estrazione multi-vista e nell’analisi del comportamento della memoria in uno stile para-sincrono. Palutke [16] ha sfruttato un meccanismo di condivisione della memoria per rilevare i processi nascosti dai dati di memoria. Presentano tre nuovi metodi che impediscono la memoria di spazio utente dannoso di apparire negli strumenti di analisi e rendere inaccessibile la memoria dal punto di vista degli analisti di sicurezza. Wang et al. [17] ha adottato il metodo di analisi della memoria fisica di Windows basato sul KPCR (kernel’S Regione di controllo del processore) Struttura, che ha risolto i problemi del giudizio della versione e la traduzione dell’indirizzo del sistema operativo. È diventato sempre più impegnativo condurre forensi di memoria utilizzando i metodi di cui sopra per i codici dannosi dannali. È difficile rilevare se ci sono comportamenti dannosi in un gran numero di file PE in memoria attraverso un’analisi manuale professionale, il che lo rende una direzione di ricerca molto impegnativa.
2.2. Rilevamento di malware
Gli approcci di rilevamento del codice dannoso sono popolari tra i ricercatori della sicurezza della rete. Per giudicare se il file EXE è un software dannoso, l’intero file EXE statico viene gestito utilizzando un algoritmo di apprendimento automatico [18]. Lo svantaggio di questo metodo è che se la quantità di dati nel set di dati era enorme, durante il processo di addestramento dei dati è stato generato un carico di grandi dimensioni. Nel modo proposto da Bozkir et al. [9], i file binari dei campioni dannosi vengono convertiti in immagini e le immagini trasformate sono classificate dalle macchine vettoriali di supporto dei classificatori (SVM), potenziamento del gradiente estremo (XGBoost) e foreste casuali. Marín et al. [19] caratteri stampabili estratti dai file PE per il rilevamento tramite l’apprendimento automatico. Li et al. [20] ha proposto un approccio di rilevamento di malware a base di CNN. Il modello VGG-16 è stato usato come modello di treno in cui i filtri convoluzionali erano della dimensione 3 × 3. Zhang et al. [21] ha proposto un metodo di classificazione per malware. Il processo ha estratto le caratteristiche della struttura semantica del codice in base a un’analisi del flusso di dati e ha utilizzato reti convoluzionali del grafico per rilevare le caratteristiche strutturali semantiche. L’accuratezza del rilevamento di questo metodo era 95.8%. Wadkar et al. [22] ha proposto un metodo di rilevamento evolutivo per malware in base al modello SVM. Il metodo proposto da Han et al. [23] analizza il malware in base alla sua struttura e comportamento.
Successivamente, sono stati utilizzati diversi classificatori, vale a dire la foresta casuale, l’albero decisionale, la CNN e XGBoost, per classificare i dati di input. Huang et al. [24] ha sviluppato un metodo di rilevamento del malware utilizzando l’apprendimento profondo e la visualizzazione basata sull’API di Windows. Genera visualizzazioni statiche utilizzando funzionalità statiche recuperate dai file di esempio. Lu XD et al. [25] ha proposto un approccio di rilevamento di Code Deep Forection (MCDF) dannoso. Nel processo, i file binari sono stati convertiti in immagini in scala di grigi, che sono state utilizzate per la formazione e il test del modello MCDF.
Come discusso in precedenza, la maggior parte dei metodi di ricerca ha utilizzato strutture di dati di memoria e connessioni tra i processi per la forense di memoria e il rilevamento del codice dannoso. È spesso difficile trovare malware specifici usando questi metodi. Alcuni metodi precedentemente proposti [5,12,26] hanno analizzato file di memoria specifici; Un altro modo precedentemente riportato [14] esamina il registro nella memoria. Uno studio precedente [9] ha proposto un metodo che converte i file di memoria in immagini per l’analisi attraverso l’apprendimento automatico. Nei metodi di ricerca esistenti, il set di dati è fondamentalmente dati statici o solo un singolo file di processo. Il comportamento dannoso iniettato in altri processi non può essere rilevato. Estrariamo tutti i processi e i file DLL dalla memoria per rilevare il codice dannoso, in particolare gli attacchi senza fila. Inoltre, massimizziamo la creazione di set di dati PE di memoria estraendo file dannosi dalla memoria. Infine, costruiamo un modello di apprendimento profondo che si adatta ai nostri dati. Le tecniche tipiche anti-malware si basano principalmente su firme per determinare se il software contiene un codice dannoso. Uroz et al. [14] ha sviluppato il plug -in volatilità Sigcheck, che recupera i file eseguibili da un dump di memoria e calcola la sua firma digitale (se possibile). Lo hanno testato su dump di memoria di Windows 7 x86 e x64. Il loro metodo richiede l’acquisizione del file PE completo e la sua velocità di rilevamento si abbassa sempre man mano che il codice è eseguito. Tuttavia, rilevando frammenti di file, il nostro metodo è più efficiente. Eseguendo diversi set di esperimenti sul set di dati prodotto, concludiamo che il frammento di dati 4096 byte alla testa del file PE nella memoria viene utilizzato per il rilevamento e il tasso di accuratezza è 97.48%.
3. Tecnologia di estrazione del file PE di memoria
3.1. Analisi della memoria
Memory Forensics si basa sull’immagine di memoria’S file binario. È difficile individuare e analizzare le preziose informazioni dall’immagine di memoria scaricata. Sebbene un processo sia molto simile a un programma in superficie, il concetto di un processo è essenzialmente diverso. Un programma è una sequenza statica di istruzioni. Il processo è un’operazione dinamica che contiene la sequenza di esecuzione e varie risorse per eseguire il programma. In Windows Memory Forensics, le prove ottenute e l’ordine di ottenere le prove per l’analisi differiscono in base ai diversi requisiti forensi. Tuttavia, l’avvio dello studio con i processi in esecuzione è spesso preferito perché il personale forense può capire quali applicazioni sono in esecuzione e cosa stanno facendo queste applicazioni attraverso l’analisi del processo.
Attraverso una struttura di elenco collegata bidirezionalmente ActiveProcessLinks, il sistema Windows può attraversare tutti i processi in esecuzione nel sistema. La chiave per l’analisi del processo è ottenere il puntatore all’elenco dei processi di sistema collegati a bidirezionale. Come mostrato nella Figura 1.
Il contenuto CR3 e la modalità di traduzione dell’indirizzo sono determinati in base alla struttura KPCR. Il breve processo è il seguente: Struttura KPCR -> membro KPCRB -> membro Procerstate -> Membro di registrazione speciale -> Registro CR3;
PSActiveProcessHead è determinato in base alla struttura KPCR e il processo è il seguente: Struttura KPCR -> KDVersionBlock -> PSActiveProcesshead;
Per ottenere informazioni sui processi, “PSActiveProcesshead” E “ActiveProcessLinks” vengono utilizzati per identificare i processi di sistema; Pertanto, può essere attraversato un elenco collegato a due vie e tutte le attività del processo possono essere elencate.
3.2. Memory Forensics
L’algoritmo di dump dei file PE in memoria è mostrato in algoritmo 1. Poiché il file di immagine di memoria da scaricare è molto grande, dobbiamo ottenere l’indirizzo fisico esatto per scaricare il file PE richiesto. L’indirizzo di base della directory della pagina di processo ottenuta nella tecnologia di analisi della memoria è contrassegnato come p. Il nome file del file PE modificato memorizzato nel file specificato viene inserito nell’algoritmo. L’algoritmo 1 può scaricare i dati dello spazio PE specificato nel file specificato.
In primo luogo, individuare la tabella della directory di pagina (riga1) per il valore dell’indirizzo di base della directory di pagina. Leggi la voce della directory della pagina (PDE) nella tabella della directory della pagina e determina se la voce della directory è vuota. Se la voce della directory non è vuota, contrassegna la voce della directory di pagina come D. Se D & 1 è uguale a 1, segna il valore di D & 0xfffff000 come indirizzo fisico della tabella di pagina specificata dalla voce della directory come t. Se D & 1 non è uguale a 1, procedere alla prossima voce della directory di pagina non vuota;
In secondo luogo, leggi la prima voce di pagina non vuota della tabella della pagina. Le voci della tabella della pagina sono contrassegnate T e se T & 1 è uguale a 1, contrassegnare il valore di T & 0xFFFFF000 come T come l’indirizzo fisico della pagina fisica specificata dalla voce della pagina. Individua l’indirizzo fisico nell’immagine di memoria, leggi il contenuto della pagina di memoria fisica e scarica i dati PE di una singola memoria nel file specificato nell’immagine di memoria tramite l’indirizzo fisico specificato. L’algoritmo (dalle righe da 2 a 15) attraversa l’intera tabella dei contenuti della pagina.
Attraverso l’analisi della memoria e la tecnologia dump di memoria, possiamo estrarre il file PE di memoria richiesto dal file di immagine di memoria scaricata del sistema per creare il nostro set di dati.
Algoritmo 1 Algoritmo di dump spaziale di processo. 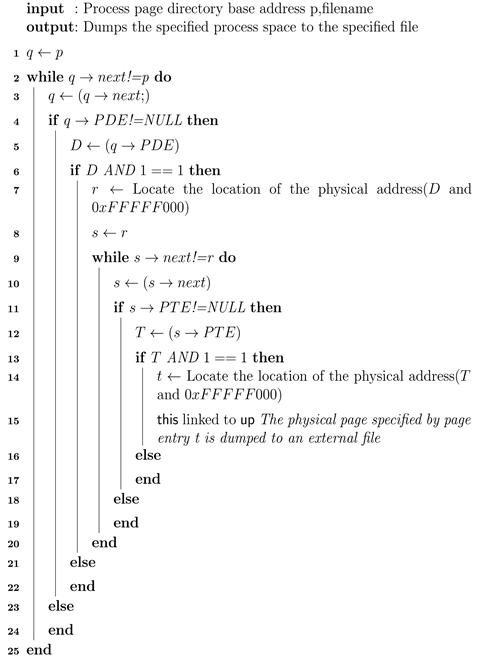
4. L’approccio
In questa sezione, spieghiamo in dettaglio il flusso di lavoro dell’intero processo. La descrizione del flusso di lavoro è illustrata nella Figura 2.
4.1. Raccolta di dati di memoria
Per quanto riguarda la ricerca sui dati dinamici, Wei [27] ha utilizzato KDD99 per esperimenti, più studi [28,29] hanno usato la struttura del kernel come set di dati per il rilevamento dinamico e un altro studio [5] ha utilizzato il file binario estratto da un singolo processo per convertirlo in un’immagine per l’analisi. I file DLL relativi al processo non sono ancora stati sfruttati. Per massimizzare i file dannosi nella memoria, estraiamo tutti i file di processo e DLL dal dump di memoria e creato un set di dati.
Prima di tutto, i software comuni (Office, Video, Audio e Games ET.) nel sistema Windows vengono scaricati. Quindi vengono eseguiti i software e i file di processo di memoria vengono scaricati. Principalmente, i file di dump di memoria vengono scaricati ogni 10 minuti e l’operazione viene ripetuta dieci volte. I file PE vengono scaricati più volte perché il software non carica tutti i file in memoria in fase di esecuzione. Per raccogliere campioni dannosi, i file PE statici dannosi vengono scaricati dal Codice malizioso di Virusshare e Malshare, librerie ampiamente utilizzate dai ricercatori [30,31], quindi campioni dannosi vengono eseguite in macchine virtuali. Il metodo di estrazione dei campioni dannosi dinamici è lo stesso di quello dei campioni benigni. I campioni dannosi vengono scaricati a un certo intervallo.
Infine, si ottengono un totale di 4896 campioni di dati. Per identificare se i campioni estratti sono campioni benigni o dannosi, i campioni benigni e dannosi sono autenticati attraverso l’interfaccia API di virust.
4.2. Preelaborazione del set di dati
4.2.1. Conversione del tipo di dati
Il set di dati del file di memoria è considerevolmente diverso dal set di dati di testo dell’elaborazione del linguaggio naturale. Precediamo prima il set di dati utilizzando la segmentazione delle parole in linguaggio naturale; cioè, convertendo i dati binari in singole parole e quindi conducendo l’incorporazione delle parole. Tuttavia, quando il modello viene utilizzato per addestrare i campioni elaborati, il risultato di allenamento è inferiore, con una precisione di circa 0.5, che non ha alcun valore per la classificazione della dicotomia. Dopo aver condotto ricerche, si è scoperto che il file binario PE di memoria ha molti 0 consecutivi che compaiono nel file, che non possono essere effettivamente appresi per i dati dopo la segmentazione delle parole. Diversi studi [9,32] hanno convertito i dati binari in immagini come set di dati. Uno studio precedente [14] ha appreso direttamente i file binari durante la preelaborazione dei dati. La Figura 3 mostra le nostre operazioni sulla trasformazione del tipo di dati del set di dati. L’intervallo di valori del numero binario a 8 bit è 0–255 e il valore dell’immagine è anche 0–255. Poiché le reti neurali convoluzionali si comportano bene nella classificazione delle immagini, convertiamo ogni otto bit binari del codice dannoso in decimale, rendendolo una forma simile ai valori numerici delle immagini. I dati di allenamento devono essere tagliati alla stessa lunghezza prima di essere aggiunti al modello di allenamento. Per prima cosa aggiungiamo 1 ai dati nel set di dati, quindi per i dati più minori della lunghezza, 0 viene utilizzato per compilare i dati per evitare di miscelazione con i dati effettivi.
4.2.2. Selezione del segmento
Il campione di set di dati prende un frammento del campione per l’allenamento. Sono adottati tre metodi per intercettare parte dei dati nel campione.
Come mostrato nella Figura 4, l’intestazione del campione è selezionata per la frammentazione e le lunghezze dell’intestazione per la frammentazione sono 32, 64, 128, 256, 512, 1024, 2048, 4096, 10.000 e 30.000 bytes. L’effetto di prendere lunghezze diverse dei frammenti del campione sul modello’La precisione di S si osserva attraverso gli esperimenti. Inoltre, il metodo di formazione dei frammenti di campionamento può anche migliorare l’efficienza di rilevamento del modello e ridurre significativamente il tempo impiegato per il rilevamento del campione;
Come mostrato nella Figura 5, la coda del campione è selezionata per la frammentazione in modo tale che l’influenza delle diverse posizioni del frammento sull’accuratezza della formazione possa essere giudicata. La coda viene scelta per estrarre il frammento del campione e la lunghezza estratta è la stessa della lunghezza estratta dall’intestazione, quindi l’effetto delle diverse posizioni può essere eseguito meglio;
Come mostrato nella Figura 6, i campioni per la frammentazione sono selezionati in modo casuale. Per riflettere meglio l’influenza delle diverse posizioni sui risultati sperimentali, campioni con la stessa lunghezza del frammento ma altre posizioni vengono estratte casualmente per ciascun campione.
4.3. Il nostro modello
Per affrontare i problemi che i file Dynamic PE sono incompleti e il rilevamento professionale di malware è difficile, viene proposto un framework di modelli profondi per apprendere le caratteristiche dei file Dynamic PE per raggiungere lo scopo della classificazione. Il piccolo frammento dei file di memoria PE (256 byte) mostra buoni risultati di rilevamento.
Nel processo di selezione del modello di apprendimento profondo, la memoria lunga a breve termine [33] (LSTM) viene prima utilizzata per gli esperimenti. LSTM è relativamente maturo nel campo dell’elaborazione del linguaggio naturale [34,35,36]. Tuttavia, i risultati sperimentali mostrano che il costo del tempo dell’allenamento del modello è superiore a quello per la CNN. A causa delle complesse e diverse forme di codice dannoso, le funzionalità estratte dalla CNN hanno caratteristiche di invarianza della traduzione [37]. Poiché la posizione del codice dannoso non è fissa, la CNN è più adatta per il rilevamento del codice dannoso nei file binari PE. Inoltre, con la lunghezza crescente dei frammenti di sequenza, la quantità di calcolo del modello LSTM sarà molto grande e la procedura richiede tempo. Sebbene la durata dell’addestramento del modello ordinario della CNN sia più breve di quella dell’LSTM, l’effetto di addestramento della CNN è simile a quello di LSTM in termini di accuratezza. La nostra architettura modello è progettata per massimizzare l’apprendimento da campioni preelaborati, come mostrato nella Figura 7. Abbiamo adottato un modello di rete con una struttura a 12 strati basata sulla CNN, in cui abbiamo usato principalmente più livelli convoluzionali per il modello’Architettura S. Per evitare l’adattamento eccessivo del modello durante l’allenamento, abbiamo aggiunto più livelli di abbandono. Lo strato di abbandono generale nasconde un quarto dei nodi neuroni. Nello studio che ha proposto la famosa struttura VGG, Simonyan e Zisserman [21] hanno osservato che per un determinato campo di ricezione, le prestazioni del piccolo kernel convoluzionale impilato sono migliori di quelle del kernel convoluzionale di grandi dimensioni perché più livelli non lineari possono aumentare la profondità della rete. Quindi, i kernel di convoluzione usati in questo studio sono piccoli. Per l’ottimizzatore nell’apprendimento profondo, il tasso di accuratezza di Adamo è risultato essere migliore di quello del SGD. Pertanto, Adamo è stato adottato e è stata adottata una funzione di perdita incrociata per la funzione di perdita della propagazione del retro del profondo. Il set di dati pre-elaborato nella sezione 4.2 sono dati monodimensionali, quindi la rete neurale convoluzionale monodimensionale (CNN1D) è adottata nel nostro modello. La differenza tra CNN1D e CNN è che la CNN viene utilizzata principalmente per il rilevamento di immagini bidimensionali, mentre la CNN1D viene utilizzata per il rilevamento di dati monodimensionali. Usiamo CNN1D per inserire dati monodimensionali nel modello con una modalità multicanale, quindi eseguiamo il calcolo della traduzione continua da parte del kernel convolution. I valori dei tag vengono confrontati utilizzando la funzione softmax. Infine, la funzione di perdita di entropia incrociata viene utilizzata per la propagazione posteriore per ottimizzare il modello; Pertanto, il raggiungimento del rilevamento accurato del rilevamento del codice dannoso può essere ottenuto con alta precisione. La procedura di elaborazione del modello LSTM è simile al metodo sopra. I dati monodimensionali preelaborati sono inoltre inseriti nel modello LSTM per l’addestramento e il rilevamento del codice dannoso.
4.4. Algoritmo di rete neurale
Questa sezione introduce l’algoritmo nel modello di rete neurale progettato per questo studio.
Le caratteristiche di uscita dei primi, secondi e terzi strati di convoluzione nell’ambiente Pytorch possono essere espresse come:
o u t (n i, c o u t j) = b i a s (c o u t j, k) + ∑ k = 0 c i n – 1 w e i g h t (c o u t j, k) × i n p u t (n i, k)
dove n è la dimensione del batch, c è la dimensione del canale, L è la lunghezza della sequenza e la distorsione è il valore di offset della rete neurale. Batch si riferisce al numero di campioni elaborati in lotti, poiché i campioni sono divisi in diversi gruppi. Il numero di campioni in ciascun gruppo è la dimensione del batch, i è l’indice dei gruppi di campioni, j è l’indice del numero di campioni e k è l’indice del canale di input.
La lunghezza della sequenza di output comprendente i livelli di prima, seconda e terza convoluzione viene calcolata usando la seguente equazione:
L o u t = ⌊ l i n + 2 × p a d d i n g – d i l a t i o n (k e r n e l _ s i z e – 1) – 1 s t r i d e + 1 ⌋
dove lfuori è la lunghezza della sequenza di output, lIn è la lunghezza della sequenza di input, l’imbottitura è la lunghezza di riempimento, la dilatazione è la dimensione della convoluzione della cavità, che è impostata su 1, il kernel_size è la dimensione del kernel convoluzione e il passo è la dimensione del passaggio.
I parametri di input del livello appiattito vengono calcolati utilizzando i parametri di output del livello di pooling. La sequenza viene appiattita usando uno strato appiattito, quindi trasformata in due nodi neuronici da uno strato completamente connesso e infine classificata da una funzione Softmax.
Lo strato Softmax, che è l’ultimo strato dello strato nascosto, vale a dire il classificatore, è espresso come:
y k = e x p (a k) ∑ i = 1 n e x p (a i)
L’Exp (X) indica la funzione esponenziale di Ex (E è Napier’S costante = 2.7182. ), n rappresenta il numero totale di neuroni nello strato di output e yK rappresenta l’output dei neuroni K nello strato di uscita, in cui il numeratore è la funzione esponenziale del segnale di ingresso aK del neurone K e il denominatore è la somma delle funzioni esponenziali di tutti i segnali di input.
La funzione di perdita del modello di rete neurale adotta la funzione di perdita di entropia incrociata Min-Batch:
E = – 1 m ∑ m ∑ k t m k l o g y m k
dove m rappresenta il numero di campioni di set di addestramento, tMk rappresenta il valore dell’elemento k del campione di previsione M, yMk è la rete neurale’s output al campione di previsione M e tMk sono i dati supervisionati. Estendendo la funzione di perdita di un singolo pezzo di dati a M e dividendo per M alla fine, è possibile ottenere la funzione di perdita media di un singolo frammento di previsione. Un indicatore unificato indipendentemente dai dati di addestramento può essere ottenuto attraverso tale media.
Attraverso le equazioni (1) e (2), possiamo calcolare ogni strato convoluzionale’S Dimensioni di input e output. Nel nostro modello, i parametri di input del livello completamente connesso devono essere calcolati manualmente quando si allena segmenti campione di dimensioni diverse. Calcolo di ogni strato’La lunghezza è complicata attraverso la formula sopra. Osservando e calcolando il modello di rete neurale che abbiamo costruito, abbiamo ottenuto la formula per calcolare la lunghezza di ingresso del livello completamente connesso nel nostro modello:
F l a t t e n i n = ((s a m p l e l e n – 1) m a x p o o l s i z e) – 2 m a x p o l s i z e 2
FalttenIn rappresenta la lunghezza di ingresso del livello completamente connesso, campionelen rappresenta la lunghezza del campione di ingresso, maxpoolmisurare significa la dimensione del livello di pooling e Conv_Channel rappresenta la dimensione del canale di uscita dell’ultimo livello convoluzionale. Assumendo la lunghezza del frammento di 2048 come esempio, solo il livello di convoluzione e il livello di pooling influiscono sulla dimensione dei dati e gli altri livelli di rete neurale prima del livello completamente connesso non influiscono sulla dimensione dei dati. Il nostro modello ha tre strati di convoluzione e tre strati di raggruppamento e le dimensioni del kernel di convoluzione dei tre strati di convoluzione sono rispettivamente 3, 4 e 5. Il raggruppamento massimo viene utilizzato per lo strato di pooling e i tre livelli di pooling sono tutti impostati su 4. Nel nostro modello, l’imbottitura del livello di convoluzione è impostata su 0, quindi la lunghezza dei dati sarà ridotta di 1 dopo ogni convoluzione. Si restringe di un fattore quattro con ogni raggruppamento. L’ordine del pooling convolutivo nel nostro modello è convoluzione, raggruppamento, convoluzione, convoluzione, raggruppamento e raggruppamento; Dopo il raggruppamento della convoluzione del nostro modello, la lunghezza dei dati con una lunghezza del frammento di campione di 2048 viene prima ridotta di 1, quindi la lunghezza è ridotta di quattro volte. Sottraendo l’output dello strato precedente di 1 due volte e due volte riducendolo di quattro volte, la lunghezza del campione diventa 31. Infine, moltiplicando 31 per il numero di canali di output dell’ultimo livello convoluzionale è il parametro di input del livello completamente connesso. La Figura 7 mostra il processo di calcolo dettagliato della lunghezza di input dello strato di appiattimento nella sezione della rete neurale.
Le impostazioni dettagliate dei parametri del modello di rete neurale sono introdotte nella sezione 5.3.
5. Panoramica sperimentale
5.1. Ambiente operativo e set di dati
La CPU hardware del nostro esperimento è il processore Intel (R) Core (TM) I7-11800H, configurato con due memoria 8G; Scheda grafica Nvidia Geforce RTX 3050. L’ambiente software è un sistema operativo Windows10 a 64 bit e VMware, che installa macchine virtuali di Windows 7 e Windows XP per eseguire campioni dannosi. L’ambiente per la costruzione e la gestione del framework di apprendimento profondo è Python 3.7, Anaconda Conda 4.11.0 e Pytorch Torch1.10.1. Il set di dati viene generato come segue: raccolta di campioni statici da VirusShare e Malshare, eseguendo i campioni nella macchina virtuale, scaricando le informazioni sulla memoria e i processi di estrazione e file DLL dai dati di memoria.
5.2. Metriche di valutazione
Per rilevare il codice dannoso, utilizziamo i quattro indici di valutazione della classificazione binaria: precisione, precisione, misurazione F e richiamo [38]. F-Measure implica che un indice può riflettere sia l’accuratezza che le velocità di richiamo.