

Χρησιμοποιεί κακόβουλο λογισμικό μνήμης?
Μόνο στη μνήμη: κακόβουλο λογισμικό – ένα αόριστο TTP
Εάν η Legacy AV, η Whitelisting, η Sandboxing και ακόμη και οι μέθοδοι μηχανικής μάθησης δεν μπορούν’αριστερά? Οι οργανισμοί μπορούν να προστατεύσουν τον εαυτό τους λαμβάνοντας μια ολοκληρωμένη προσέγγιση που συνδυάζει πολλαπλές μεθόδους.
Περίληψη:
Το κακόβουλο λογισμικό μόνο για μνήμη, γνωστό και ως κακόβουλο λογισμικό, έχει αποκτήσει προσοχή λόγω των πρόσφατων παραβιάσεων δεδομένων, όπως η Heist Data Heist. Αυτοί οι τύποι προγραμμάτων κακόβουλου λογισμικού φορτώνονται σε μνήμη RAM και δεν εγκαθίστανται στον σκληρό δίσκο, καθιστώντας τους δύσκολο να ανιχνεύσουν. Ωστόσο, υπάρχουν διάφοροι λόγοι για τους οποίους το κακόβουλο λογισμικό μόνο για μνήμη δεν πρέπει να αποτελεί σημαντικό μέλημα.
Βασικά σημεία:
- Τα περισσότερα κακόβουλα λογισμικού μόνο για μνήμη δεν μπορούν να επιμείνουν μέσω μιας επανεκκίνησης, καθιστώντας ευκολότερη την καθαρή.
- Τα προγράμματα Antimalware είναι πιο αποτελεσματικά στη μνήμη σάρωσης από τη σάρωση ενός σκληρού δίσκου ή SSD.
- Δεν υπάρχουν στοιχεία που να υποδηλώνουν ότι το κακόβουλο λογισμικό μόνο για μνήμη είναι πιο δύσκολο να ανιχνευθεί από άλλους τύπους κακόβουλου λογισμικού.
- Το κακόβουλο λογισμικό μόνο για μνήμη έχει περάσει εδώ και πολύ καιρό και τα προγράμματα Antimalware μπορούν εύκολα να τα εντοπίσουν.
Ερωτήσεις:
- Ποια είναι τα βασικά σημεία σχετικά με το κακόβουλο λογισμικό μνήμης μόνο?
Τα βασικά σημεία σχετικά με το κακόβουλο λογισμικό μόνο για τη μνήμη είναι ότι τα περισσότερα κακόβουλα λογισμικά μόνο για μνήμη δεν μπορούν να επιβιώσουν σε επανεκκίνηση, τα προγράμματα αντιμέτρου δεν έχουν κανένα πρόβλημα στη μνήμη σάρωσης, δεν υπάρχουν στοιχεία που να υποδηλώνουν ότι το κακόβουλο λογισμικό μόνο για μνήμη είναι πιο δύσκολο να ανιχνευθεί και το κακόβουλο λογισμικό μόνο για μνήμη έχει περάσει για μεγάλο χρονικό διάστημα. - Γιατί είναι ευκολότερο να καθαρίσετε το κακόβουλο λογισμικό μόνο?
Το κακόβουλο λογισμικό μόνο για μνήμη μπορεί εύκολα να καθαριστεί με επανεκκίνηση του υπολογιστή, καθώς δεν παραμένει μέσω επανεκκίνησης. - Γιατί τα προγράμματα Antimalware είναι πιο αποτελεσματικά στη μνήμη σάρωσης?
Η μνήμη σάρωσης είναι πολύ ταχύτερη από τη σάρωση ενός σκληρού δίσκου ή SSD και υπάρχει λιγότερη μνήμη RAM για σάρωση σε σύγκριση με το χώρο του δίσκου. - Υπάρχουν κάποια στοιχεία που υποδηλώνουν ότι το κακόβουλο λογισμικό μόνο για μνήμη είναι πιο δύσκολο να ανιχνευθεί?
Όχι, δεν υπάρχουν στοιχεία που να υποδηλώνουν ότι το κακόβουλο λογισμικό μόνο για μνήμη είναι πιο δύσκολο να ανιχνευθεί. Τα προγράμματα Antimalware μπορούν εύκολα να ανιχνεύσουν κακόβουλο λογισμικό μόνο για μνήμη. - Το κακόβουλο λογισμικό μόνο για μνήμη ήταν εδώ και πολύ καιρό?
Ναι, το κακόβουλο λογισμικό μόνο για μνήμη έχει περάσει εδώ και πολύ καιρό. Το SQL Slammer Worm το 2003 είναι ένα παράδειγμα κακόβουλου λογισμικού μνήμης μόνο. - Ποια είναι τα οφέλη του κακόβουλου λογισμικού μόνο?
Τα οφέλη του κακόβουλου λογισμικού μόνο για τη μνήμη περιλαμβάνουν ευκολότερο καθαρισμό μέσω επανεκκίνησης, ταχύτερη σάρωση από προγράμματα αντιμέτρου και κανένα στοιχείο που να υποδηλώνει αυξημένη δυσκολία ανίχνευσης. - Ποιες είναι μερικές κοινές παρανοήσεις σχετικά με το κακόβουλο λογισμικό μνήμης μόνο?
Ορισμένες κοινές παρανοήσεις σχετικά με κακόβουλο λογισμικό μνήμης είναι ότι είναι πιο δύσκολο να ανιχνευθούν και πιο επικίνδυνα από άλλους τύπους κακόβουλου λογισμικού. - Πώς συγκρίνεται το κακόβουλο λογισμικό μνήμης μόνο με άλλους τύπους κακόβουλου λογισμικού?
Το κακόβουλο λογισμικό μόνο για μνήμη δεν είναι εγγενώς πιο επικίνδυνο ή πιο δύσκολο να ανιχνευθεί από άλλους τύπους κακόβουλου λογισμικού. - Υπάρχουν μελέτες σχετικά με την ανίχνευση κακόβουλου λογισμικού μνήμης μόνο?
Δεν υπήρξαν μελέτες που να δείχνουν ότι το κακόβουλο λογισμικό μόνο για μνήμη είναι πιο δύσκολο να ανιχνευθεί ή έχει αυξήσει τα ψευδή αρνητικά. - Γιατί οι οργανισμοί δεν πρέπει να ανησυχούν για το κακόβουλο λογισμικό μόνο για μνήμη?
Οι οργανισμοί δεν πρέπει να ανησυχούν για το κακόβουλο λογισμικό μόνο για τη μνήμη, επειδή μπορούν εύκολα να καθαριστούν, τα προγράμματα αντιμονοπωλιακής λογισμικού μπορούν να το ανιχνεύσουν αποτελεσματικά και δεν υπάρχουν στοιχεία που να υποδηλώνουν αυξημένη δυσκολία στην ανίχνευση.
Απαντήσεις:
- Το κακόβουλο λογισμικό μόνο για μνήμη μπορεί να συνοψιστεί από τα ακόλουθα βασικά σημεία: τα περισσότερα κακόβουλα προγράμματα μνήμης δεν μπορούν να επιβιώσουν σε μια επανεκκίνηση, τα προγράμματα αντιμονοπωλιακών λογισμικών είναι αποτελεσματικά στη μνήμη σάρωσης, δεν υπάρχουν στοιχεία που να υποδηλώνουν αυξημένη δυσκολία στην ανίχνευση και το κακόβουλο λογισμικό μόνο για μνήμη έχει περάσει για μεγάλο χρονικό διάστημα. Αυτά τα βασικά σημεία παρέχουν διαβεβαίωση ότι το κακόβουλο λογισμικό μόνο για μνήμη δεν πρέπει να αποτελεί μείζονα ανησυχία.
- Το κακόβουλο λογισμικό μόνο για μνήμη είναι ευκολότερο να καθαριστεί επειδή δεν μπορεί να επιμείνει μέσα από μια επανεκκίνηση. Κλείνοντας το αρχικό σημείο εισόδου και επανεκκίνηση του υπολογιστή, το κακόβουλο λογισμικό μόνο για μνήμη αφαιρείται αποτελεσματικά χωρίς την ανάγκη για εκτεταμένη αναζήτηση και καθαρισμό.
- Τα προγράμματα Antimalware είναι πιο αποτελεσματικά στη μνήμη σάρωσης σε σύγκριση με τη σάρωση ενός σκληρού δίσκου ή SSD. Η μνήμη σάρωσης είναι σημαντικά ταχύτερη και απαιτεί λιγότερους πόρους, επιτρέποντας στα προγράμματα αντιμέτρου να ανιχνεύουν γρήγορα και να αφαιρέσουν κακόβουλο λογισμικό μνήμης.
- Δεν υπάρχουν στοιχεία που να υποδηλώνουν ότι το κακόβουλο λογισμικό μόνο για μνήμη είναι πιο δύσκολο να ανιχνευθεί από άλλους τύπους κακόβουλου λογισμικού. Τα προγράμματα Antimalware ανιχνεύουν εύκολα κακόβουλο λογισμικό μνήμης και δεν υπήρξαν μελέτες που να δείχνουν αυξημένη δυσκολία ανίχνευσης ή υψηλότερα ψευδώς αρνητικά.
- Το κακόβουλο λογισμικό μόνο για μνήμη έχει περάσει εδώ και πολύ καιρό, με παραδείγματα όπως το SQL Slammer Worm το 2003. Παρά την ταχεία εξάπλωση και πιθανές επιπτώσεις, το κακόβουλο λογισμικό μόνο για μνήμη είναι εύκολα ανιχνεύσιμη από προγράμματα αντιμέτρου.
- Τα οφέλη του κακόβουλου λογισμικού μόνο για τη μνήμη περιλαμβάνουν ευκολότερο καθαρισμό μέσω της επανεκκίνησης. Καθώς το κακόβουλο λογισμικό μόνο για μνήμη δεν μπορεί να επιμείνει μέσα από μια επανεκκίνηση, απλά επανεκκινώντας τον υπολογιστή καθαρίζει τυχόν ίχνη του κακόβουλου λογισμικού, εξαλείφοντας την ανάγκη για πολύπλοκες διαδικασίες καθαρισμού.
- Ορισμένες κοινές παρανοήσεις σχετικά με κακόβουλο λογισμικό μνήμης είναι ότι είναι πιο δύσκολο να ανιχνευθούν και πιο επικίνδυνα από άλλους τύπους κακόβουλου λογισμικού. Ωστόσο, τα προγράμματα Antimalware δεν έχουν κανένα πρόβλημα να ανιχνεύσουν κακόβουλο λογισμικό μνήμης και δεν υπάρχουν στοιχεία που να υποστηρίζουν αυξημένο κίνδυνο σε σύγκριση με άλλους τύπους κακόβουλου λογισμικού.
- Το κακόβουλο λογισμικό μόνο για μνήμη δεν είναι εγγενώς πιο επικίνδυνο ή πιο δύσκολο να ανιχνευθεί από άλλους τύπους κακόβουλου λογισμικού. Παρόλο που προσφέρει ορισμένα πλεονεκτήματα στους επιτιθέμενους, όπως η αποφυγή ορισμένων μεθόδων ανίχνευσης, τα προγράμματα αντιμονοπωλιακού λογισμικού είναι εξοπλισμένα για τον εντοπισμό και την κατάργηση του κακόβουλου λογισμικού μόνο για μνήμη.
- Δεν υπήρξαν μελέτες που να δείχνουν ότι το κακόβουλο λογισμικό μόνο για μνήμη είναι πιο δύσκολο να ανιχνευθεί ή έχει αυξήσει τα ψευδή αρνητικά. Τα προγράμματα Antimalware μπορούν να ανιχνεύσουν αξιόπιστα κακόβουλο λογισμικό μόνο και δεν υπάρχουν στοιχεία που να υποδηλώνουν ότι οι τρέχουσες μέθοδοι ανίχνευσης είναι ανεπαρκείς.
- Οι οργανισμοί δεν πρέπει να ανησυχούν για το κακόβουλο λογισμικό μόνο για τη μνήμη, επειδή μπορούν εύκολα να καθαριστούν, τα προγράμματα αντιμέτρου είναι αποτελεσματικά στην ανίχνευση και δεν υπάρχουν στοιχεία που να υποδηλώνουν αυξημένη δυσκολία στην ανίχνευση. Με την υιοθέτηση μιας ολοκληρωμένης προσέγγισης που συνδυάζει πολλαπλές μεθόδους ασφαλείας, οι οργανισμοί μπορούν να προστατεύσουν αποτελεσματικά από κακόβουλο λογισμικό μόνο για μνήμη.
Αυτή η ιστορία, “Πρέπει να ανησυχείτε για κακόβουλο λογισμικό μνήμης μόνο?,”Δημοσιεύθηκε αρχικά στο Infoworld.com. Συνεχίστε τις τελευταίες εξελίξεις στην ασφάλεια του δικτύου και διαβάστε περισσότερα από το blog του συμβούλου ασφαλείας του Roger Grimes στο Infoworld.com. Για τα τελευταία νέα της τεχνολογίας των επιχειρήσεων, ακολουθήστε το Infoworld.com στο Twitter.
Μόνο στη μνήμη: κακόβουλο λογισμικό – ένα αόριστο TTP
Η χρήση του κακοποιού κακόβουλου λογισμικού και η ζωή από τις τεχνικές της γης (LOTL) από τους ηθοποιούς απειλής στον κυβερνοχώρο (CTAs) αυξάνεται με τα χρόνια με τα χρόνια. Τα δεδομένα από τα εργαλεία τελικού σημείου WatchGuard υποδεικνύουν ότι περίπου το 80 % των επιθέσεων FILLESS ή LOTL το 2020 εντοπίστηκαν ήδη μέχρι το τέλος του 2021. Τα δεδομένα της Symantec δείχνουν επίσης σημαντική αύξηση της κακόβουλης χρήσης των νόμιμων εργαλείων από το 2019 έως το 2020. Η έρευνα του Ινστιτούτου Ponemon για τους επαγγελματίες της πληροφορικής που είναι υπεύθυνοι για τη διαχείριση κινδύνου τελικού σημείου επιβεβαιώνει περαιτέρω τις αυξανόμενες περιπτώσεις άχρηστου κακόβουλου λογισμικού και χρήσης LOTL σε επιχειρηματικά περιβάλλοντα.
Βιβλιογραφικές αναφορές:
Φιγούρα 1: Δεδομένα από το 2019-2020 που απεικονίζουν κακόβουλη χρήση νόμιμων εργαλείων. (Πηγή: Symantec)
Ένας αρθρογράφος ασφαλείας από το 2005, ο Roger Grimes κατέχει περισσότερες από 40 πιστοποιήσεις υπολογιστών και έχει συντάξει δέκα βιβλία για την ασφάλεια των υπολογιστών.
Πνευματική ιδιοκτησία © 2014 IDG Communications, Inc.
Μόνο στη μνήμη: κακόβουλο λογισμικό – ένα αόριστο TTP
Εάν η Legacy AV, η Whitelisting, η Sandboxing και ακόμη και οι μέθοδοι μηχανικής μάθησης δεν μπορούν’αριστερά? Οι οργανισμοί μπορούν να προστατεύσουν τον εαυτό τους λαμβάνοντας μια ολοκληρωμένη προσέγγιση που συνδυάζει πολλαπλές μεθόδους.
Εάν ανησυχείτε για κακόβουλο λογισμικό μνήμης μόνο?
Η πρόσφατη Heist Data Heist με περισσότερα από 40 εκατομμύρια αρχεία πιστωτικών καρτών έχει πολλές ανησυχίες για τον αντίκτυπο του κακόβουλου λογισμικού μόνο για μνήμη. Το Malware Target, μια παραλλαγή του Blackpos, είναι μέρος μιας οικογένειας Trojan Horse γνωστή ως Trojan.Καραμέλα. Μετά την αρχική εκμετάλλευση, αυτά τα προγράμματα απλά φορτώνονται σε μνήμη RAM – δεν εγκαθίστανται στον σκληρό δίσκο.
Η έλλειψη “αποτυπώματος λογισμικού” καθιστά τα προγράμματα κακόβουλου λογισμικού μόνο για RAM. Μερικοί άνθρωποι λένε ότι είναι πραγματικά φοβισμένοι. Πρέπει να ανησυχούμε για αυτά περισσότερο από άλλα προγράμματα κακόβουλου λογισμικού?
[Επίσης στο Infoworld: 13 δύσκολες ερωτήσεις σχετικά με την ασφάλεια του υπολογιστή. | Συνεχίστε με βασικά ζητήματα ασφάλειας με το κεντρικό ενημερωτικό δελτίο ασφαλείας του InfoWorld. ]
Ο πανικός πάνω από τους Trojans μόνο για μνήμη μου θυμίζει όλες τις προφητείες της Doomsday για το κακόβουλο λογισμικό rootkit, το οποίο θα μπορούσε εύκολα να κρύψει από προγράμματα προστασίας από ιούς.”Φέρνει στο μυαλό παρελθόν υστερία σχετικά με τα σκουλήκια bot, τους ιούς προσκόλλησης ηλεκτρονικού ταχυδρομείου, τους ιούς εκκίνησης και τους αεροπειρατές DNS. Αυτοί οι πρόσφατα ανακαλυφθέντες τύποι κακόβουλου λογισμικού ακούγονται αρχικά τρομακτικά, αλλά τα προγράμματα αντιμέτρων τώρα εντοπίζουν εύκολα όλα αυτά. Η μόνη πρόκληση για το λογισμικό Antimalware είναι να συμβαδίζει με τον τεράστιο αριθμό νέων προγραμμάτων κακόβουλου λογισμικού που εμφανίζονται καθημερινά. Ανίχνευση ολόκληρου τύπος το κακόβουλο λογισμικό σπάνια υπήρξε πρόβλημα.
Στην πραγματικότητα, το κακόβουλο λογισμικό μόνο για μνήμη είναι ένα είδος ευλογίας, για μερικούς λόγους.
Πρώτον, τα περισσότερα κακόβουλα λογισμικού μόνο για μνήμη δεν μπορούν να ζήσουν μέσω επανεκκίνησης. Είναι αλήθεια ότι αν δεν έχετε διορθώσει αυτό που το επέτρεψε να αποκτήσει αρχική πρόσβαση στην πρώτη θέση, το κακόβουλο λογισμικό θα επιστρέψει. Αλλά πόσο ωραίο είναι ότι αν κλείσετε την αρχική οπή εισόδου, μια απλή επανεκκίνηση θα καθαρίσει το χάος κακόβουλου λογισμικού? Δεν υπάρχει κυνήγι γύρω από το σκληρό δίσκο που προσπαθεί να βρει όλα τα μέρη που έχει τροποποιηθεί ή στα οποία μπορεί να κρύβεται, να μην τραβήξει τους ιούς από τα εκτελέσιμα οικοδεσπότες και να προσπαθεί να αποφασίσει πώς να βάλει ξανά το Humpty-Dumpty μαζί, δεν αναρωτιέστε αν έχετε τα πάντα. Απλά επανεκκινήστε τον υπολογιστή σας και χαλαρώστε. Φαντάζομαι στον εαυτό μου σε μια παραλία στο Μεξικό, κλωτσώντας πίσω με μια χρυσή μπύρα.
Δεύτερον, τα προγράμματα Antimalware αγαπούν να σαρώσουν τη μνήμη για κακούς ηθοποιούς. Είναι τα αντικείμενα που δεν τους επιβραδύνουν. Η μνήμη σάρωσης μπορεί να είναι κυριολεκτικά χιλιάδες φορές ταχύτερα από τη σάρωση ενός σκληρού δίσκου – είναι ακόμη πολύ, πολύ πιο γρήγορα από τη σάρωση ενός SSD. Επιπλέον, φυσικά, υπάρχει πολύ λιγότερη μνήμη RAM από το δίσκο για σάρωση. Οι σαρωτές αντιμέτρων θα ήθελαν να κολλήσουν στη μνήμη αν μπορούσαν. Το χτύπημα της απόδοσης θα εξατμιστεί.
Τρίτον, δεν έχω δει μελέτες που να λένε ότι το κακόβουλο λογισμικό μόνο για μνήμη είναι πιο δύσκολο να ανιχνευθεί ή έχει πραγματοποιήσει αυξημένα ψευδή αρνητικά. Αυτό ανησυχούν οι περισσότεροι άνθρωποι. Δεν έχω δει ακόμη πραγματικά στοιχεία.
Τέλος, παρόλο που το Blackpos ήταν εδώ και μόνο μερικά χρόνια, είχαμε κακόβουλο λογισμικό μόνο. Το SQL Slammer Worm του 2003, για παράδειγμα, ήταν μόνο μνήμη. Μέχρι σήμερα, η SQL Slammer εξακολουθεί να κατέχει τον τίτλο του ταχύτερα εξαπλωμένου σκουληκιού. Εκμεταλλεύτηκε σχεδόν κάθε μη διαμορφωμένο SQL Server στο Διαδίκτυο σε περίπου 10 λεπτά. Αλλά τόσο άσχημα όσο ήταν, μου άρεσε ο καθαρισμός: patched το διακομιστή και επανεκκίνηση. Φλόγα! Το κακό πράγμα έφυγε για πάντα. Ω ναι, ανιχνεύεται εύκολα από κάθε πρόγραμμα προστασίας από ιούς στον κόσμο.
Έτσι, όχι, δεν φοβάμαι το κακόβουλο λογισμικό μνήμης μόνο. Αντίθετα, διασχίζω τα δάχτυλά μου και ελπίζω ότι όλα τα κακόβουλα λογισμικά γίνονται μόνο μνήμη.
Αυτή η ιστορία, “Πρέπει να ανησυχείτε για κακόβουλο λογισμικό μνήμης μόνο?,”Δημοσιεύθηκε αρχικά στο Infoworld.com. Συνεχίστε τις τελευταίες εξελίξεις στην ασφάλεια του δικτύου και διαβάστε περισσότερα από το blog του συμβούλου ασφαλείας του Roger Grimes στο Infoworld.com. Για τα τελευταία νέα της τεχνολογίας των επιχειρήσεων, ακολουθήστε το Infoworld.com στο Twitter.
- Οι 10 πιο ισχυρές εταιρείες στον κυβερνοχώρο
- 7 Τάσεις καυτών στον κυβερνοχώρο (και 2 πηγαίνουν κρύα)
- Τα τρωτά σημεία Apache log4j: ένα χρονοδιάγραμμα
- Χρήση του πλαισίου NIST Cybersecurity για την αντιμετώπιση του οργανωτικού κινδύνου
- 11 Εργαλεία δοκιμής διείσδυσης Η χρήση των επαγγελματιών
- Ασφάλεια
- Ασφάλεια δεδομένων και πληροφοριών
- Κακόβουλο λογισμικό
Ένας αρθρογράφος ασφαλείας από το 2005, ο Roger Grimes κατέχει περισσότερες από 40 πιστοποιήσεις υπολογιστών και έχει συντάξει δέκα βιβλία για την ασφάλεια των υπολογιστών.
Copyright © 2014 IDG Communications, Inc.
Μόνο στη μνήμη: κακόβουλο λογισμικό – ένα αόριστο TTP
Τα δεδομένα της βιομηχανίας αποκαλύπτουν σημαντική ανάπτυξη στους ηθοποιούς απειλής στον κυβερνοχώρο »(CTAs’) Χρήση κακοποιών κακόβουλου λογισμικού και ζουν από τις τεχνικές της γης (LOTL) τα τελευταία χρόνια.
- Μέχρι το τέλος του 2021, είχαν τα εργαλεία τελικού σημείου του WatchGuard “ήδη ανιχνεύθηκε περίπου το 80 τοις εκατό των κακοποιών ή που ζούσαν από τις επιθέσεις γης που είδαν για όλο το 2020.”
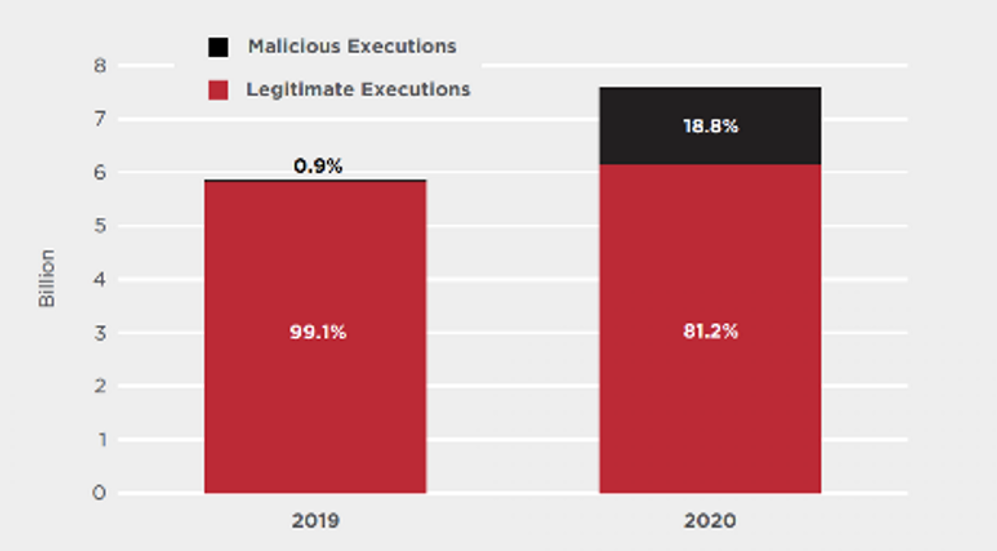
- Στο σχήμα 1, βλέπουμε το Symantec’Τα δεδομένα S από το 2019 και το 2020 αποκαλύπτουν μια αξιοσημείωτη ακίδα στο CTAS’ κακόβουλη χρήση νόμιμων εργαλείων κατά τη διάρκεια αυτής της περιόδου.
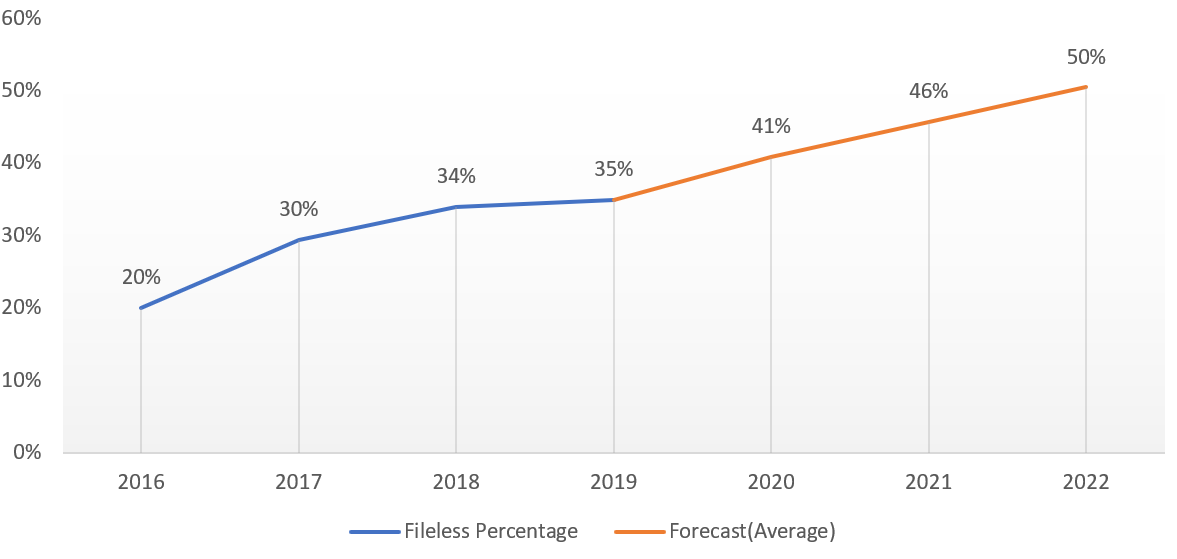
- Το σχήμα 2 δείχνει τον τρόπο με τον οποίο οι περιπτώσεις του κακοποιού κακόβουλου λογισμικού και της χρήσης LOTL αυξάνονται σε επιχειρηματικά περιβάλλοντα, καθώς το Ινστιτούτο Ponemon έμαθε από την τοποθέτηση των επαγγελματιών πληροφορικής που είναι υπεύθυνοι για τη διαχείριση του κινδύνου τελικού σημείου.
Εικόνα 1: Δεδομένα από το 2019-2020 που απεικονίζουν κακόβουλη χρήση νόμιμων εργαλείων. (Πηγή: Symantec)
Εικόνα 2: Πρόβλεψη με βάση το Ινστιτούτο Ponemon’S Ετήσια Μελέτη 2020 σχετικά με την Έρευνα Κινδύνου Ασφαλείας Τελικού Σημείου. (Πηγή: Morphisec)
Τι είναι κακόβουλο λογισμικό?
Το κακόβουλο λογισμικό είναι κακόβουλο λογισμικό που εκτελείται στη μνήμη, σε αντίθεση με το παραδοσιακό κακόβουλο λογισμικό που γράφει στο δίσκο χρησιμοποιώντας κακόβουλα εκτελέσιμα. Μετά τη μόλυνση, οι CTA που αναπτύσσουν κακόβουλο λογισμικό συνήθως αξιοποιούν το νόμιμο σύστημα και τα εργαλεία διαχείρισης όπως το Windows PowerShell και το Windows Management Instrumentation (WMI) για να επιτύχουν την επιμονή από το LOTL. Μόλις το CTAS δημιουργήσει μια θέση στο θύμα’το περιβάλλον, μπορούν στη συνέχεια να κλιμακώσουν τα προνόμια και να μετακινηθούν πλευρικά σε όλο το δίκτυο (βλ. Εικόνα 3). Οι κοινές παραλλαγές κακόβουλου λογισμικού περιλαμβάνουν το Darkwatchman, το Panda Stealer, το Bitrat και το Avemariarat.
Εικόνα 3: Η αλυσίδα επίθεσης κακόβουλου λογισμικού χωρίς παραδείγματα με παραδείγματα

Το κακόβουλο λογισμικό τρέχει στη μνήμη και αξιοποιεί αξιόπιστα εργαλεία, οπότε συχνά φαίνεται καλοήθη σε συστήματα ανίχνευσης και ανίχνευσης προστασίας με βάση την υπογραφή και εισβολής. Αυτό του επιτρέπει να λειτουργεί ανιχνεύσιμο, να διατηρήσει εμμονή και να αφήσει οργανισμούς θύματος χωρίς τα κατάλληλα εργαλεία αποτελεσματικά τυφλά σε μια συνεχιζόμενη διείσδυση. Πράγματι, οργανώσεις’ Η έντονη εξάρτηση από τα εργαλεία που βασίζονται σε υπογραφή για την υπεράσπιση των δικτύων τους είναι πιθανόν ένας σημαντικός οδηγός που παρακινάει τα CTA να επιτεθούν σε δίκτυα με κακόβουλο λογισμικό.
Υπερασπίζεται το κακόβουλο λογισμικό
Σύμφωνα με την ανάλυση της ομάδας Cyber Threat Intelligence (CTI) στο κέντρο ανταλλαγής και ανάλυσης πληροφοριών πολλαπλών κρατικών πληροφοριών (MS-ISAC), οι CTA θα συνεχίσουν να συμβιβάζουν τους οργανισμούς με αυξανόμενο ρυθμό παρά την ευρύτερη οργανωτική άμυνα σε βάθος ανάπτυξη. Στην πραγματικότητα, η εκτίμησή τους υποδηλώνει ότι το κακόβουλο λογισμικό και το LOTL θα ανέλθουν στο 50% των συνολικών επιθέσεων έναντι των επιχειρηματικών περιβαλλόντων το 2022, αντιστοιχώντας έτσι τη συχνότητα των επιθέσεων που βασίζονται σε αρχεία για πρώτη φορά. (Αυτή η ανισότητα θα μπορούσε να προκύψει από CTAs’ χωρίς κακόβουλο λογισμικό χρήσης εκτός οργανισμών’ αμυντικές εφαρμογές.·
Οι οργανισμοί θα τεθούν σε μια σημαντικά καλύτερη στάση εναντίον του κακόβουλου λογισμικού χωρίς να περιμένουν να δώσουν προτεραιότητα στα εξής:
- Η άμυνα σε βάθος: Μια αποτελεσματική υπεράσπιση του κυβερνοχώρου κατά του κακοποιού κακόβουλου λογισμικού θα αξιοποιήσει μια στρατηγική υπεράσπισης σε βάθος, η οποία στρώνει βασικές βέλτιστες πρακτικές και εργαλεία, όπως ενεργά διατηρούμενα τείχη προστασίας, συστήματα πρόληψης IDS/εισβολής, ESS, κατάτμηση δικτύου, βάσης δικτύου και συστήματος,.
- Υπηρεσίες ασφαλείας CIS Endpoint (ESS): Παρέχεται από το Κέντρο Ασφάλειας Διαδικτύου (CIS). Στη συνέχεια, προειδοποιεί ή αποκλείει την ανώμαλη δραστηριότητα ανάλογα με τη φύση της απειλής.
- CIS Critical Controls Security (CIS Controls): Μια προτεραιότητα και συνιστώμενη σειρά ενεργειών για την υπεράσπιση του κυβερνοχώρου, οι έλεγχοι CIS παρέχουν συγκεκριμένους και ενεργητικούς τρόπους προστασίας από τις πιο διαδεδομένες και επικίνδυνες επιθέσεις
Άλλες σημαντικές άμυνες που αφορούν το κακόβουλο λογισμικό περιλαμβάνουν τη χρήση ενός συνδυασμού διεπαφής σάρωσης αντιμονοπωλιακών λογισμικών (AMSI), παρακολούθησης συμπεριφοράς, σάρωσης μνήμης, περιορισμού της PowerShell σε υπογεγραμμένα σενάρια ή περιορίζοντας το PowerShell και το WMI σε συγκεκριμένους σταθμούς εργασίας, περιορίζοντας τη μακροεντολή που επιτρέπει μόνο συγκεκριμένους λογαριασμούς που χρειάζονται πρόσβαση και την εκκίνηση στην προστασία στο Endpoint.
Πρόσθετη προστασία για SLTT
Όταν πρόκειται για την καταπολέμηση του κακόβουλου λογισμικού, u.μικρό. Κρατικές, τοπικές, φυλετικές και εδαφικές (SLTT) Κυβερνητικές οντότητες χρειάζονται όλη τη βοήθεια που μπορούν να πάρουν. Ευτυχώς, αυτοί οι οργανισμοί μπορούν να βρουν άφθονη υποστήριξη με την ένταξη στο MS-ISAC. Ως μέλη, θα έχουν πρόσβαση σε τακτικές ειδοποιήσεις απειλής και ενημερώσεις που διερευνούν το τοπίο απειλής, συμπεριλαμβανομένης της εξέλιξης του κακόβουλου λογισμικού. Θα συμμετάσχουν επίσης στο πρόγραμμα κοινής χρήσης δεικτών που καταπιεί/αποκλείει κακόβουλους δείκτες σε πραγματικό χρόνο. Αυτή η νοημοσύνη, καθώς και οι άλλοι πόροι της MS-ISAC, θα βοηθήσουν τους SLTTs να προστατευθούν από το κακόβουλο λογισμικό που προχωρούν προς τα εμπρός.
Άπιαστο κακόβουλο λογισμικό Εξηγούνταν
Το κακόβουλο λογισμικό είναι ένας τύπος κακόβουλης δραστηριότητας που χρησιμοποιεί εγγενή, νόμιμα εργαλεία ενσωματωμένα σε ένα σύστημα για την εκτέλεση μιας επίθεσης στον κυβερνοχώρο. Σε αντίθεση με το παραδοσιακό κακόβουλο λογισμικό, το κακόβουλο λογισμικό δεν απαιτεί από έναν εισβολέα να εγκαταστήσει οποιονδήποτε κωδικό σε στόχο’σύστημα S, καθιστώντας δύσκολο να εντοπιστεί.
Αυτή η τεχνική χωρίς καταφύγια για τη χρήση των εγγενών εργαλείων για τη διεξαγωγή μιας κακόβουλης επίθεσης αναφέρεται μερικές φορές ως ζωντανή από τη γη ή τα lolbins
Κοινές τεχνικές κακόβουλου λογισμικού
Ενώ οι επιτιθέμενοι’t πρέπει να εγκαταστήσουν τον κώδικα για να ξεκινήσουν μια αδικαιολόγητη επίθεση κακόβουλου λογισμικού, πρέπει ακόμα να αποκτήσουν πρόσβαση στο περιβάλλον, ώστε να μπορούν να τροποποιήσουν τα εγγενή εργαλεία του για να εξυπηρετήσουν τους σκοπούς τους. Η πρόσβαση και οι επιθέσεις μπορούν να επιτευχθούν με διάφορους τρόπους, όπως μέσω της χρήσης:
- Εκμεταλλευτείτε κιτ
- Απεριωμένα εγγενή εργαλεία
- Κακόβουλο λογισμικό κατοίκου μητρώου
- Κακόβουλο λογισμικό μνήμης
- Χωρίς καραμέλα ransomware
- Κλεμικά διαπιστευτήρια
Εκμεταλλευτείτε κιτ
Οι εκμεταλλεύσεις είναι κομμάτια κώδικα, ακολουθίες εντολών ή συλλογές δεδομένων και κιτ εκμετάλλευσης είναι συλλογές εκμεταλλεύσεων. Οι αντίπαλοι χρησιμοποιούν αυτά τα εργαλεία για να επωφεληθούν από τα τρωτά σημεία που είναι γνωστό ότι υπάρχουν σε ένα λειτουργικό σύστημα ή σε εγκατεστημένη εφαρμογή.
Οι εκμεταλλεύσεις είναι ένας αποτελεσματικός τρόπος για να ξεκινήσετε μια επίθεση κακόβουλου λογισμικού, επειδή μπορούν να εγχυθούν απευθείας στη μνήμη χωρίς να απαιτείται να γράφεται τίποτα στο δίσκο. Οι αντίπαλοι μπορούν να τα χρησιμοποιήσουν για να αυτοματοποιήσουν τους αρχικούς συμβιβασμούς σε κλίμακα.
Η εκμετάλλευση αρχίζει με τον ίδιο τρόπο, ανεξάρτητα από το αν η επίθεση είναι άχρηστη ή χρησιμοποιεί παραδοσιακό κακόβουλο λογισμικό. Συνήθως, ένα θύμα παρασύρεται μέσω ηλεκτρονικού ταχυδρομείου ηλεκτρονικού “ψαρέματος” ή κοινωνικής μηχανικής. Το κιτ εκμετάλλευσης περιλαμβάνει συνήθως εκμεταλλεύματα για μια σειρά τρωτών σημείων και μια κονσόλα διαχείρισης που ο εισβολέας μπορεί να χρησιμοποιήσει για τον έλεγχο του συστήματος. Σε ορισμένες περιπτώσεις, το κιτ εκμετάλλευσης θα περιλαμβάνει τη δυνατότητα να σαρώσουν το στοχευμένο σύστημα για τρωτά σημεία και στη συνέχεια να δημιουργήσουν και να ξεκινήσουν μια προσαρμοσμένη εκμετάλλευση εν πτήσει.
Κακόβουλο λογισμικό κατοίκου μητρώου
Το Malware Resident Resident είναι κακόβουλο λογισμικό που εγκαθίσταται στο μητρώο των Windows προκειμένου να παραμείνει επίμονος ενώ αποφεύγει την ανίχνευση.
Συνήθως, τα συστήματα των Windows μολύνονται μέσω της χρήσης ενός προγράμματος Dropper που κατεβάζει ένα κακόβουλο αρχείο. Αυτό το κακόβουλο αρχείο παραμένει ενεργό στο στοχευμένο σύστημα, το οποίο το καθιστά ευάλωτο στην ανίχνευση με λογισμικό προστασίας από ιούς. Το κακόβουλο λογισμικό μπορεί επίσης να χρησιμοποιήσει ένα πρόγραμμα Dropper, αλλά δεν το κάνει’Τ ΛΗΨΗ ΑΝΤΙΜΕΤΩΠΙΣΗ ΑΡΧΕΙΟ. Αντ ‘αυτού, το ίδιο το πρόγραμμα Dropper γράφει κακόβουλο κώδικα κατευθείαν στο μητρώο των Windows.Ο κακόβουλος κώδικας μπορεί να προγραμματιστεί να ξεκινά κάθε φορά που ξεκινά το λειτουργικό σύστημα και δεν υπάρχει κακόβουλο αρχείο που θα μπορούσε να ανακαλυφθεί – ο κακόβουλος κώδικας είναι κρυμμένος σε εγγενή αρχεία που δεν υπόκεινται σε ανίχνευση AV.
Η παλαιότερη παραλλαγή αυτού του τύπου επίθεσης είναι οι Poweliks, αλλά πολλοί έχουν προκύψει από τότε, συμπεριλαμβανομένων των Kovter και Gootkit. Το κακόβουλο λογισμικό που τροποποιεί τα κλειδιά μητρώου είναι πολύ πιθανό να παραμείνει σε θέση μη ανιχνευμένο για παρατεταμένες χρονικές περιόδους.
Κακόβουλο λογισμικό μνήμης
Το κακόβουλο λογισμικό μόνο στη μνήμη βρίσκεται μόνο στη μνήμη. Ένα παράδειγμα κακόβουλου λογισμικού μνήμης είναι το σκουλήκι Duqu, το οποίο μπορεί να παραμείνει ανιχνευμένο επειδή κατοικεί αποκλειστικά στη μνήμη. Duqu 2.0 έρχεται σε δύο εκδόσεις. Το πρώτο είναι ένα backdoor που επιτρέπει στον αντίπαλο να κερδίσει μια θέση σε έναν οργανισμό. Ο αντίπαλος μπορεί στη συνέχεια να χρησιμοποιήσει την προηγμένη έκδοση του DUQU 2.0, το οποίο προσφέρει πρόσθετα χαρακτηριστικά όπως η αναγνώριση, η πλευρική κίνηση και η εξάσκηση δεδομένων. Duqu 2.Το 0 έχει χρησιμοποιηθεί για την επιτυχή παραβίαση των εταιρειών στη βιομηχανία τηλεπικοινωνιών και τουλάχιστον έναν γνωστό πάροχο λογισμικού ασφαλείας.
Χωρίς καραμέλα ransomware
Οι αντίπαλοι δεν περιορίζονται σε έναν τύπο επίθεσης. Χρησιμοποιούν οποιαδήποτε τεχνολογία που θα τους βοηθήσει να καταγράψουν το ωφέλιμο φορτίο τους. Σήμερα, οι επιτιθέμενοι ransomware χρησιμοποιούν τεχνικές χωρίς καταφύγια για να ενσωματώσουν κακόβουλο κώδικα σε έγγραφα μέσω της χρήσης γλωσσικών γλωσσών όπως οι μακροεντολές ή για να γράψουν τον κακόβουλο κώδικα απευθείας στη μνήμη μέσω της χρήσης μιας εκμετάλλευσης. Το ransomware στη συνέχεια εξαπατά τα εγγενή εργαλεία όπως το PowerShell για να κρυπτογραφήσει τα αρχεία ομήρων χωρίς να έχουν γράψει ποτέ μία γραμμή στο δίσκο.
Κλεμικά διαπιστευτήρια
Οι επιτιθέμενοι μπορεί να αρχίσουν μια επιθετική επίθεση μέσω της χρήσης κλεμμένων διαπιστευτηρίων, ώστε να μπορούν να έχουν πρόσβαση στο στόχο τους με το πρόσχημα ενός νόμιμου χρήστη. Μόλις εισέλθει, ο εισβολέας μπορεί να χρησιμοποιήσει εγγενή εργαλεία όπως τα Windows Management Instrumentation (WMI) ή το PowerShell για να διεξαγάγει την επίθεσή τους. Μπορούν να δημιουργήσουν επιμονή με την απόκρυψη κώδικα στο μητρώο ή στον πυρήνα ή με τη δημιουργία λογαριασμών χρηστών που τους παρέχουν πρόσβαση σε οποιοδήποτε σύστημα επιλέγουν.
Πώς οι αντίπαλοι χρησιμοποιούν επιθέσεις χωρίς να αποφεύγουν την ασφάλειά σας
Κατεβάστε αυτό το Λευκό Βίβλο για να μάθετε τη λεπτομερή ανατομία μιας άσχημης εισβολής, συμπεριλαμβανομένου του αρχικού συμβιβασμού, της εντολής και του ελέγχου, της κλιμάκωσης των προνομίων και της καθιέρωσης εμμονής.
Στάδια μιας επιθετικής επίθεσης
Για να αποδείξουμε πώς μπορεί να λειτουργήσει μια επίθεση, παρακάτω, είναι ένα infographic που απεικονίζει μια πραγματική άσχημη εισβολή που αποκαλύπτεται από την ομάδα Crowdstrike Services Coundent Response (IR).
Στάδιο #1: Αποκτήστε πρόσβαση
Τεχνική: Εκμεταλλευτείτε απομακρυσμένα ένα ευπάθεια και χρησιμοποιήστε το scripting web για απομακρυσμένη πρόσβαση (π.χ. China Chopper)
Ο εισβολέας αποκτά απομακρυσμένη πρόσβαση στο θύμα’S σύστημα, για να δημιουργήσει ένα beachhead για την επίθεσή του.
Στάδιο #2: Κλέβες διαπιστευτήρια
Τεχνική: Εκμεταλλευτείτε απομακρυσμένα ένα ευπάθεια και χρησιμοποιήστε το scripting web για απομακρυσμένη πρόσβαση (π.χ. Mimikatz)
Χρησιμοποιώντας την πρόσβαση που αποκτήθηκε στο προηγούμενο βήμα, ο εισβολέας προσπαθεί τώρα να λάβει διαπιστευτήρια για το περιβάλλον που έχει συμβιβαστεί, επιτρέποντάς του να μετακομίσει εύκολα σε άλλα συστήματα σε αυτό το περιβάλλον.
Στάδιο #3: Διατηρήστε επιμονή
Τεχνική: Τροποποιήστε το μητρώο για να δημιουργήσετε ένα backdoor (π.χ. Παράκαμψη Sticky Keys)
Τώρα, ο επιτιθέμενος δημιουργεί ένα backdoor που θα του επιτρέψει να επιστρέψει σε αυτό το περιβάλλον κατά βούληση, χωρίς να χρειάζεται να επαναλάβει τα αρχικά βήματα της επίθεσης.
Στάδιο #4: Δεδομένα εξώθησης
Τεχνική: Χρησιμοποιεί το σύστημα αρχείων και το ενσωματωμένο βοηθητικό πρόγραμμα συμπίεσης για τη συλλογή δεδομένων, στη συνέχεια χρησιμοποιεί το FTP για να μεταφορτώσει τα δεδομένα
Στο τελικό βήμα, ο επιτιθέμενος συγκεντρώνει τα δεδομένα που θέλει και το προετοιμάζει για εξαίρεση, αντιγράφοντας τα σε μία θέση και στη συνέχεια συμπιέζει χρησιμοποιώντας εύκολα διαθέσιμα εργαλεία συστήματος όπως το Compact. Ο εισβολέας αφαιρεί τα δεδομένα από το θύμα’το περιβάλλον μεταφορτώντας το μέσω FTP.
Πώς να ανιχνεύσετε κακόβουλο λογισμικό
Εάν η Legacy AV, η Whitelisting, η Sandboxing και ακόμη και οι μέθοδοι μηχανικής μάθησης δεν μπορούν’αριστερά? Οι οργανισμοί μπορούν να προστατεύσουν τον εαυτό τους λαμβάνοντας μια ολοκληρωμένη προσέγγιση που συνδυάζει πολλαπλές μεθόδους.
Βασιστείτε σε δείκτες επίθεσης αντί για δείκτες συμβιβασμού μόνο
Οι δείκτες της επίθεσης (IOAs) είναι ένας τρόπος για να ακολουθήσετε μια προληπτική προσέγγιση κατά των επιθέσεων χωρίς καταφύγια. Το IOAS δεν επικεντρώνεται στα βήματα του τρόπου με τον οποίο εκτελείται μια επίθεση – αντ ‘αυτού, αναζητούν σημάδια ότι μια επίθεση μπορεί να βρίσκεται σε εξέλιξη.
Τα IOA περιλαμβάνουν σημάδια όπως η εκτέλεση κώδικα, οι πλευρικές κινήσεις και οι ενέργειες που φαίνεται να προορίζονται να καλύψουν την αληθινή τους πρόθεση.
Οι IOA δεν επικεντρώνονται στον τρόπο εκκίνησης ή εκτέλεσης των βημάτων. Δεν έχει σημασία αν η δράση ξεκίνησε από ένα αρχείο στον σκληρό δίσκο ή από μια τεχνική χωρίς καύση. Το μόνο πράγμα που έχει σημασία είναι η δράση που εκτελείται, πώς σχετίζεται με άλλες ενέργειες, τη θέση της σε μια ακολουθία και τις εξαρτημένες ενέργειές της. Αυτοί οι δείκτες αποκαλύπτουν τις πραγματικές προθέσεις και στόχους πίσω από τις συμπεριφορές τους και τα γεγονότα γύρω τους.
Επειδή οι επιθέσεις χωρίς εκμεταλλεύσεις εκμεταλλεύονται νόμιμες γλώσσες σεναρίων όπως το PowerShell και δεν είναι ποτέ γραμμένες στον εαυτό τους δίσκους, δεν εντοπίζονται από μεθόδους με βάση την υπογραφή, τις λευκές και το sandboxing και το sandboxing. Ακόμη και οι μέθοδοι εκμάθησης μηχανών δεν αναλύουν κακόβουλο λογισμικό. Αλλά η IOAS αναζητά ακολουθίες γεγονότων που πρέπει να εκτελούν ακόμη και κακόβουλο λογισμικό για να επιτύχουν την αποστολή του.
Και επειδή οι ΙΟΑ εξετάζουν την πρόθεση, το πλαίσιο και τις ακολουθίες, μπορούν ακόμη και να ανιχνεύσουν και να εμποδίσουν τις κακόβουλες δραστηριότητες που εκτελούνται χρησιμοποιώντας έναν νόμιμο λογαριασμό, κάτι που συμβαίνει συχνά όταν ένας εισβολέας χρησιμοποιεί κλεμμένα διαπιστευτήρια.
Χρησιμοποιήστε το κυνήγι απειλής απειλής
Το κυνήγι απειλής για κακόβουλο λογισμικό είναι χρονοβόρο και επίπονο έργο που απαιτεί τη συλλογή και την εξομάλυνση των εκτεταμένων ποσοτήτων δεδομένων. Ωστόσο, είναι ένα απαραίτητο συστατικό σε μια υπεράσπιση που προστατεύει από επιθέσεις χωρίς κακία, και για τους λόγους αυτούς, η πιο ρεαλιστική προσέγγιση για την πλειονότητα των οργανισμών είναι να μετατρέψουν την απειλή τους σε έναν προμηθευτή εμπειρογνωμόνων.
Οι διαχειριζόμενες υπηρεσίες κυνηγιού απειλών βρίσκονται σε ρολόι όλο το εικοσιτετράωρο, αναζητώντας προληπτικά εισβολές, παρακολούθηση του περιβάλλοντος και αναγνωρίζοντας λεπτές δραστηριότητες που θα περάσουν απαρατήρητες από τις τυποποιημένες τεχνολογίες ασφαλείας.
Πώς το CrowdStrike μπορεί να αποτρέψει τις επιθέσεις χωρίς καταφύγια στον οργανισμό σας
Όπως είδαμε, οι τεχνικές χωρίς άξια είναι εξαιρετικά δύσκολες για να ανιχνεύσετε εάν βασίζεστε σε μεθόδους με βάση την υπογραφή, Sandboxing, Whitelisting ή ακόμα και μεθόδους προστασίας μηχανικής μάθησης.
Προκειμένου να προστατεύσει από μυστικές, αιχμηρές επιθέσεις, το Crowdstrike συνδυάζει μοναδικά πολλαπλές μεθόδους σε μια ισχυρή και ολοκληρωμένη προσέγγιση που προσφέρει απαράμιλλη προστασία από τελικό σημείο. Η πλατφόρμα Crowdstrike Falcon® προσφέρει προστασία τελικού σημείου νέας γενιάς, επόμενης γενιάς μέσω ενός μόνο ελαφρού παράγοντα και προσφέρει μια σειρά συμπληρωματικών μεθόδων πρόληψης και ανίχνευσης:
- Το απόθεμα εφαρμογών ανακαλύπτει τυχόν εφαρμογές που εκτελούνται στο περιβάλλον σας, βοηθώντας να βρείτε τρωτά σημεία, ώστε να μπορείτε να τις ενημερώσετε ή να τις ενημερώσετε και μπορούν’να είναι ο στόχος των κιτ εκμετάλλευσης.
- Η εκμετάλλευση μπλοκάρισμα σταματά την εκτέλεση επιθέσεων χωρίς εκμετάλλευση μέσω εκμεταλλεύσεων που εκμεταλλεύονται τα μη προσαρτημένα τρωτά σημεία.
- Οι δείκτες της επίθεσης (IOAs) εντοπίζουν και εμποδίζουν την κακόβουλη δραστηριότητα κατά τα πρώτα στάδια μιας επίθεσης, προτού να εκτελέσει πλήρως και να προκαλέσει ζημιά. Αυτή η δυνατότητα προστατεύει επίσης από νέες κατηγορίες ransomware που δεν χρησιμοποιούν αρχεία για να κρυπτογραφήσουν τα συστήματα των θυμάτων.
- Ο έλεγχος σεναρίου παρέχει εκτεταμένη ορατότητα και προστασία από επιθέσεις με βάση το σενάριο Fileles.
- Η προχωρημένη σάρωση μνήμης προστατεύει από επιθέσεις χωρίς κακομεταχείριση και χωρίς κακόβουλο λογισμικό, όπως τα εργαλεία APTS, ransomware και διπλής χρήσης, όπως η απεργία κοβαλτίου στη μνήμη.
- Η διαχείριση του κυνηγιού αναζητά ενεργά όλο το εικοσιτετράω.
Γνωρίστε τον συγγραφέα
Ο Kurt Baker είναι ο ανώτερος διευθυντής του μάρκετινγκ προϊόντων για το Falcon Intelligence στο Crowdstrike. Έχει πάνω από 25 χρόνια εμπειρίας σε ανώτερες ηγετικές θέσεις, που ειδικεύεται σε αναδυόμενες εταιρείες λογισμικού. Έχει εμπειρογνωμοσύνη στην Intelligence Intelligence Cyber, αναλύσεις ασφαλείας, διαχείριση ασφαλείας και προχωρημένη προστασία απειλών. Πριν από την είσοδό του στο Crowdstrike, ο Baker εργάστηκε σε τεχνικούς ρόλους στο Tripwire και είχε συνιδρυθεί τις νεοσύστατες επιχειρήσεις που κυμαίνονταν από λύσεις ασφαλείας επιχειρήσεων σε κινητές συσκευές. Είναι κάτοχος πτυχίου Bachelor of Arts από το Πανεπιστήμιο της Ουάσινγκτον και τώρα εδρεύει στη Βοστώνη της Μασαχουσέτης.
Μια προσέγγιση ανίχνευσης κακόβουλου λογισμικού βασισμένη στην βαθιά μαθησιακή και εγκληματολογία μνήμης
Τεχνολογία του Πανεπιστημίου Qilu (Ακαδημία Επιστημών Shandong), Κέντρο Υπολογιστών Shandong (Na-5 Tional Supercomputer Center στο Jinan), Shandong Επαρχιακό Κλειδί Εργαστήριο Δικτύων Υπολογιστών), Jinan 250014, Κίνα
Μαθηματικό Ινστιτούτο, Σερβική Ακαδημία Επιστημών και Τεχνών, 11000 Βελιγράδι, Σερβία
Συγγραφέας σε ποιον πρέπει να αντιμετωπιστεί η αλληλογραφία.
Συμμετρία 2023, 15(3), 758; https: // doi.org/10.3390/SYM15030758
Λήψη: 28 Δεκεμβρίου 2022 / Αναθεωρημένο: 22 Φεβρουαρίου 2023 / Αποδεκτό: 17 Μαρτίου 2023 / Δημοσιεύθηκε: 19 Μαρτίου 2023
Αφηρημένη
Καθώς οι επιθέσεις στον κυβερνοχώρο αναπτύσσονται πιο πολύπλοκες και εξελιγμένες, οι νέοι τύποι κακόβουλου λογισμικού γίνονται πιο επικίνδυνοι και προκλητικοί για ανίχνευση. Συγκεκριμένα, το κακοποιό κακόβουλο λογισμικό εισάγει κακόβουλο κώδικα στη φυσική μνήμη απευθείας χωρίς να αφήνει ίχνη επίθεσης σε αρχεία δίσκου. Αυτός ο τύπος επίθεσης είναι καλά κρυμμένος και είναι δύσκολο να βρεθεί ο κακόβουλος κώδικας στα στατικά αρχεία. Για κακόβουλες διαδικασίες στη μνήμη, οι μέθοδοι ανίχνευσης με βάση την υπογραφή γίνονται όλο και πιο αναποτελεσματικές. Αντιμετωπίζοντας αυτές τις προκλήσεις, το παρόν έγγραφο προτείνει μια προσέγγιση ανίχνευσης κακόβουλου λογισμικού που βασίζεται στο συνολικό νευρωνικό δίκτυο και την εγκληματολογία μνήμης. Καθώς το κακόβουλο λογισμικό έχει πολλά συμμετρικά χαρακτηριστικά, το αποθηκευμένο μοντέλο εκπαίδευσης μπορεί να ανιχνεύσει κακόβουλο κώδικα με συμμετρικά χαρακτηριστικά. Η μέθοδος περιλαμβάνει τη συλλογή εκτελέσιμων στατικών κακόβουλων και καλοήθεις δείγματα, τη λειτουργία των συλλεχθέντων δειγμάτων σε ένα sandbox και την οικοδόμηση ενός συνόλου δεδομένων φορητών εκτελέσιμων σε μνήμη μέσω της Forensics Memory. Όταν εκτελείται μια διαδικασία, δεν χρησιμοποιούνται όλο το περιεχόμενο του προγράμματος στη μνήμη, έτσι τα δυαδικά θραύσματα χρησιμοποιούνται για ανάλυση κακόβουλου λογισμικού αντί για ολόκληρα αρχεία φορητών εκτελέσιμων (PE). Τα θραύσματα αρχείων PE επιλέγονται με διαφορετικά μήκη και θέσεις. Διεξήγαμε διάφορα πειράματα στο παραγόμενο σύνολο δεδομένων για να δοκιμάσουμε το μοντέλο μας. Το αρχείο PE με 4096 bytes θραύσματος κεφαλίδας έχει την υψηλότερη ακρίβεια. Επιτύχαμε ακρίβεια πρόβλεψης μέχρι 97.48%. Επιπλέον, ένα παράδειγμα αιχμής επίθεσης απεικονίζεται στο τέλος του χαρτιού. Τα αποτελέσματα δείχνουν ότι η προτεινόμενη μέθοδος μπορεί να ανιχνεύσει αποτελεσματικά τους κακόβουλους κώδικες, ειδικά την επίθεση που δεν έχει περάσει. Η ακρίβειά του είναι καλύτερη από αυτή των κοινών μεθόδων εκμάθησης μηχανών.
1. Εισαγωγή
Με την ανάπτυξη της τεχνολογίας του Διαδικτύου, οι επιθέσεις κακόβουλου λογισμικού έγιναν πιο διαδεδομένες και εξελιγμένες. Επί του παρόντος, το κακόβουλο λογισμικό είναι ένας από τους κυρίαρχους φορείς επίθεσης που χρησιμοποιούνται από τους εγκληματίες στον κυβερνοχώρο για την εκτέλεση κακόβουλων δραστηριοτήτων [1]. Καθημερινά, το Ινστιτούτο AV-Test καταγράφει πάνω από 450.000 νέα κακόβουλα προγράμματα (κακόβουλο λογισμικό) και ενδεχομένως ανεπιθύμητες εφαρμογές (PUA) [2]. Τα προϊόντα προστασίας από ιούς εφαρμόζουν τεχνολογίες στατικής και ευρετικής ανάλυσης για την ανίχνευση κακόβουλου λογισμικού. Δυστυχώς, αυτές οι προσεγγίσεις έγιναν λιγότερο αποτελεσματικές για την ανίχνευση εξελιγμένων κακόβουλων λογισμικών που εκμεταλλεύεται τις τεχνικές παρακολούθησης και κρυπτογράφησης [3]. Συγκεκριμένα, οι επιθέσεις κακόβουλου λογισμικού που χρησιμοποιούνται άγρια χρησιμοποιούνται και προκαλούν σοβαρές απώλειες. Το κακόβουλο λογισμικό είναι ένας τύπος κακόβουλου λογισμικού που δεν βασίζεται σε αρχεία και δεν αφήνει αποτύπωμα στο δίσκο του υπολογιστή. Είναι δύσκολο να ανιχνεύσουμε άγνωστα κακόβουλα προγράμματα χωρίς να γνωρίζουμε τις υπογραφές τους.
Για την καταπολέμηση τέτοιων απειλών, διεξάγονται πολλές έρευνες σε διάφορους τομείς, συμπεριλαμβανομένης της βαθιάς μάθησης, της εγκληματολογίας μνήμης, της θεωρίας των αριθμών κ.ο.κ. [4,5,6]. Η Memory Forensics προσφέρει μοναδικές γνώσεις στην εσωτερική κατάσταση του συστήματος του πυρήνα και στα προγράμματα τρέξιμο [7]. Η μνήμη έχει υψηλό δυναμικό να περιέχει κακόβουλο κώδικα από μια λοίμωξη, εν όλω ή εν μέρει, ακόμη και αν δεν είναι ποτέ γραμμένο στο δίσκο, επειδή πρέπει να φορτωθεί στη μνήμη για εκτέλεση [8]. Ο στόχος ανάλυσης της εγκληματολογικής μνήμης είναι μια χωματερή μνήμης από όπου μπορούν να εξαχθούν τα ίχνη επίθεσης. Αντίθετα, αυτά τα ίχνη δεν είναι διαθέσιμα με τη μέθοδο της παραδοσιακής ανάλυσης δίσκου. Κατά τη διάρκεια της ανάλυσης μνήμης, τα malwares εκτελούνται σε ένα sandbox για να εμποδίσουν τα κακοποιούς να προκαλέσουν βλάβη σε ολόκληρο το σύστημα υπολογιστών, το οποίο επιτυγχάνεται με την καθιέρωση εικονικών μηχανών. Τα δεδομένα μνήμης πρέπει να συλλέγονται εγκαίρως όταν το κακόβουλο λογισμικό εκτελείται στην εικονική μηχανή (VM). Σε αυτή την εργασία, τα δεδομένα μνήμης απορρίπτονται στο δίσκο χρησιμοποιώντας τον αλγόριθμο απόρριψης μνήμης για περαιτέρω ανάλυση. Εκτός από την απόρριψη των δεδομένων μνήμης, τα κακόβουλα αρχεία εκτελέσιμων (PE) πρέπει να εξάγονται από χιλιάδες δεδομένα μνήμης ως δείγματα δεδομένων. Bozkir et al. [9] παρουσίασε μια προσέγγιση για την αναγνώριση του κακόβουλου λογισμικού, καταγράφοντας την χωματερή μνήμη των ύποπτων διαδικασιών, οι οποίες μπορούν να εκπροσωπούνται ως εικόνα RGB. Ωστόσο, η συλλογή κακόβουλων δεδομένων μνήμης με αυτόν τον τρόπο είναι ανεπαρκής. Η εξαγόμενη διαδικασία δυνητικά δεν φορτώθηκε κακόβουλο κώδικα στη μνήμη. Ορισμένες κακόβουλες διαδικασίες εγχέονται σε νέες διαδικασίες για την εκτέλεση κακόβουλων ενεργειών. Σε αυτή την περίπτωση, η εξαγωγή μιας ενιαίας κακόβουλης διαδικασίας δεν μπορεί να αντικατοπτρίζει πλήρως την κακόβουλη συμπεριφορά της διαδικασίας. Η εξαγωγή μόνο μιας κακόβουλης διαδικασίας δεν μπορεί να αντικατοπτρίζει πλήρως την αξία της ανάλυσης μνήμης. Το σύνολο δεδομένων σε αυτό το έγγραφο λαμβάνει πολλαπλές χωματερές εικόνων μνήμης και εξάγει όλες τις διαδικασίες και τα δεδομένα DLL. Με στενή ανάλυση αυτών των πληροφοριών, τα καλοήθη και κακόβουλα δεδομένα μπορούν να ταξινομηθούν μέσω μιας πλατφόρμας ανίχνευσης.
Αυτό το έγγραφο προτείνει μια μέθοδο ανίχνευσης κακόβουλου κώδικα. Ένα μοντέλο νευρωνικού δικτύου είναι κατασκευασμένο για την ανίχνευση θραυσμάτων δειγμάτων. Το θραύσμα δείγματος’Το κόστος του χρόνου μειώνεται σε σύγκριση με την ανίχνευση ολόκληρου του δείγματος. Για να μειωθεί το πρόβλημα της κρίσιμης απώλειας δεδομένων που προκαλείται από την ανίχνευση θραυσμάτων δείγματος, επιλέγουμε θραύσματα ανίχνευση διαφορετικών θέσεων και μήκους για να προσδιορίσουμε τον κατάλληλο τόπο και το μέγεθος των ανιχνευόμενων τμημάτων.
Οι κύριες συνεισφορές αυτού του εγγράφου συνοψίζονται ως εξής:
Αυτό το έγγραφο δημιουργεί ένα φορητό εκτελέσιμο σύνολο δεδομένων αρχείων (PE) στη μνήμη, το οποίο εξάγει πιο κακόβουλα δείγματα μνήμης στη διαδικασία. Το παρόν έγγραφο συλλέγει πρώτα στατικά αρχεία PE από τις γνωστές κακόβουλες βιβλιοθήκες δείγματος Virusshare και Malshare, τα οποία χρησιμοποιούνται ευρέως από ερευνητές και έχουν υψηλή πειστικότητα. Στη συνέχεια, αυτό το έγγραφο κατεβάζει το κοινό λογισμικό από την επίσημη πλατφόρμα της Microsoft. Τέλος, εκτελεί τα στατικά δείγματα στη λειτουργία εικονικών μηχανών και εκχυλίζει τα δυναμικά δείγματα για να δημιουργήσει το σύνολο δεδομένων μας
Δημιουργούμε ένα μοντέλο βασισμένο στο νευρωνικό δίκτυο (CNN) και χρησιμοποιούμε το μοντέλο για να εκπαιδεύσουμε τμήματα μνήμης για να επιτύχουμε ακριβή ανίχνευση κακόβουλου κώδικα
Δίνουμε ένα παράδειγμα της επίθεσης κακόβουλου λογισμικού στο χαρτί. Δεδομένου ότι κατασκευάζεται το σύνολο δεδομένων δυναμικού αρχείου, έχει καλή απόδοση ανίχνευσης “κανένα αρχείο” επιθέσεις και κακόβουλα δείγματα που μπορούν να ανιχνευθούν μόνο σε δυναμικά αρχεία.
2. Σχετική δουλειά
2.1. Εγκληματολογία μνήμης
Οι προσεγγίσεις της εγκληματολογίας υπολογιστών χωρίζονται στη δυναμική και στατική ανάλυση. Η στατική ανάλυση βασίζεται στην αρχή της μη εκτέλεσης του προγράμματος. Περιλαμβάνει τη διαδικασία εκχύλισης των εξαρτημάτων, των οδηγιών, της ροής ελέγχου και της κλήσης λειτουργίας των χαρακτηριστικών στατικών κωδικών αλληλουχίας, όπως η ανίχνευση ανωμαλιών [10]. Jiang et al. [11] σχεδίασε ένα σύνολο συστημάτων επαλήθευσης δυαδικών δυαδικών ακεραιότητας για να ελέγξει την ακεραιότητα των δυαδικών αρχείων σε εικονικές μηχανές. Η μέθοδος στατικής ανάλυσης είχε υψηλή κάλυψη δείγματος. Ακόμα, μια ανάλυση πολλαπλών γωνιών απαιτήθηκε για την ανίχνευση κακόβουλου κώδικα χρησιμοποιώντας τεχνολογίες όπως η παραμόρφωση, ο πολυμορφισμός, ο κώδικας και η κρυπτογράφηση [12]. Όσον αφορά τη δυναμική ανάλυση, οι περισσότερες από τις πληροφορίες στη μνήμη ήταν ελλιπείς λόγω του μηχανισμού σελίδας και αντικατάστασης της μνήμης. Το πρόγραμμα δεν μεταβίβασε όλες τις πληροφορίες στη μνήμη κατά τη διάρκεια της εκτέλεσης. Μόνο μέρος των πληροφοριών μεταφέρθηκε πρώτα στη μνήμη. Επομένως, τα πλήρη εκτελέσιμα δεδομένα δεν μπορούν να ληφθούν.
Επιπλέον, όταν ένα κακόβουλο πρόγραμμα ανιχνεύσει ότι το εργαλείο ανίχνευσης ιού/Τρώης τρέχει ή χρησιμοποιεί λογισμικό για να αποκτήσει τη μνήμη, διακόπτει αμέσως τη συμπεριφορά επίθεσης, αυτοκαταστροφή και σβήνει τα ίχνη επίθεσης. Αυτές οι συμπεριφορές αυτοκαταστροφής παρουσίασαν υψηλότερες απαιτήσεις για δειγματοληψία και ανίχνευση δεδομένων μνήμης. Otsuki et al. [13] πρότεινε μια μέθοδο εξαγωγής ιχνών στοίβας από τις εικόνες μνήμης σε ένα σύστημα Windows 64-bit. Έδειξαν την αποτελεσματικότητα του Stealth Loader αναλύοντας ένα σύνολο εκτελέσιμων windows και κακόβουλου λογισμικού που προστατεύονται από το Stealth Loader χρησιμοποιώντας σημαντικά εργαλεία δυναμικής και στατικής ανάλυσης. Uroz et al. [14] διερεύνησαν τους περιορισμούς που επιβάλλουν η εγκληματολογία μνήμης στη διαδικασία επαλήθευσης ψηφιακής υπογραφής των αρχείων που έχουν σχεδιαστεί από τα Windows PE που ελήφθησαν από χωματερή μνήμη. Αυτοί οι περιορισμοί είναι η ατέλεια δεδομένων, οι αλλαγές δεδομένων που προκαλούνται από τη μετεγκατάσταση, τα αρχεία υπογεγραμμένων καταλόγων και τις ασυνέπειες του αρχείου και της διαδικασίας. Cheng et al. [15] πρότεινε έναν αλγόριθμο ομαδοποίησης που συνειδητοποίησε τη μέθοδο ανάλυσης συσχέτισης δεδομένων αυτόματης μνήμης μέσω της ανάλυσης της κρίσιμης δομής δεδομένων του λειτουργικού συστήματος. Οι κύριες ιδέες εγγυώνται την ακρίβεια των δεδομένων στην εξαγωγή πολλαπλών προβολών και την ανάλυση της συμπεριφοράς μνήμης σε ένα Para-Symchronous Style. Ο Palutke [16] εκμεταλλεύτηκε έναν μηχανισμό κοινής χρήσης μνήμης για την ανίχνευση κρυφών διαδικασιών από δεδομένα μνήμης. Παρουσιάζουν τρεις νέες μεθόδους που εμποδίζουν την εμφάνιση του κακόβουλου χώρου χρηστών σε εργαλεία ανάλυσης και επιπλέον καθιστώντας τη μνήμη απρόσιτη από την άποψη των αναλυτών ασφαλείας. Wang et al. [17] υιοθέτησε τη μέθοδο ανάλυσης φυσικής μνήμης των Windows με βάση το KPCR (πυρήνας’S Περιοχή ελέγχου επεξεργαστή), η οποία επιλύει τα προβλήματα της κρίσης έκδοσης και τη μετάφραση διευθύνσεων του λειτουργικού συστήματος. Έγινε ολοένα και πιο δύσκολο να διεξαχθεί η εγκληματολογία μνήμης χρησιμοποιώντας τις παραπάνω μεθόδους για τους εκθετικά αυξανόμενους κακόβουλους κωδικούς. Είναι δύσκολο να ανιχνευθεί εάν υπάρχουν κακόβουλες συμπεριφορές σε μεγάλο αριθμό αρχείων PE στη μνήμη μέσω επαγγελματικής χειρωνακτικής ανάλυσης, γεγονός που την καθιστά μια πολύ δύσκολη κατεύθυνση έρευνας.
2.2. Ανίχνευση κακόβουλου λογισμικού
Οι κακόβουλες προσεγγίσεις ανίχνευσης κώδικα είναι δημοφιλείς μεταξύ των ερευνητών ασφάλειας δικτύου. Για να κρίνουμε αν το αρχείο EXE είναι κακόβουλο λογισμικό, ολόκληρο το στατικό αρχείο EXE αντιμετωπίζεται χρησιμοποιώντας έναν αλγόριθμο μηχανικής μάθησης [18]. Το μειονέκτημα αυτής της μεθόδου είναι ότι εάν το ποσό των δεδομένων στο σύνολο δεδομένων ήταν τεράστιο, δημιουργήθηκε ένα υπερμεγέθη φορτίο κατά τη διάρκεια της διαδικασίας κατάρτισης δεδομένων. Με τον τρόπο που προτάθηκε από τους Bozkir et al. [9], τα δυαδικά αρχεία των κακόβουλων δειγμάτων μετατρέπονται σε εικόνες και οι μετασχηματισμένες εικόνες ταξινομούνται από τις μηχανές διανύσματος διανυσμάτων (SVM), ακραία κλίση (XGBOOST) και τυχαίο δάσος και τυχαίο δάσος. Marín et al. [19] εξάγονται εκτυπώσιμοι χαρακτήρες από τα αρχεία PE για ανίχνευση μέσω μηχανικής μάθησης. Li et al. [20] πρότεινε μια προσέγγιση ανίχνευσης κακόβουλου λογισμικού με βάση το CNN. Το μοντέλο VGG-16 χρησιμοποιήθηκε ως μοντέλο αμαξοστοιχίας στο οποίο τα συνελικτικά φίλτρα ήταν του μεγέθους 3 × 3. Zhang et al. [21] πρότεινε μια μέθοδο ταξινόμησης για κακόβουλο λογισμικό. Η διαδικασία εξήγαγε τα χαρακτηριστικά σημασιολογικής δομής του κώδικα με βάση μια ανάλυση ροής δεδομένων και χρησιμοποίησε δίκτυα συνελικτικών γραφημάτων για την ανίχνευση των σημασιολογικών διαρθρωτικών χαρακτηριστικών. Η ακρίβεια ανίχνευσης αυτής της μεθόδου ήταν 95.8%. Wadkar et al. [22] πρότεινε μια μέθοδο εξελικτικής ανίχνευσης για κακόβουλο λογισμικό με βάση το μοντέλο SVM. Η μέθοδος που προτάθηκε από τους Han et al. [23] αναλύει το κακόβουλο λογισμικό με βάση τη δομή και τη συμπεριφορά του.
Στη συνέχεια, αρκετοί ταξινομητές, δηλαδή, τυχαία δάση, δέντρο αποφάσεων, CNN και XGBOOST, χρησιμοποιήθηκαν για την ταξινόμηση των δεδομένων εισόδου. Huang et al. [24] ανέπτυξε μια μέθοδο ανίχνευσης κακόβουλου λογισμικού χρησιμοποιώντας βαθιά εκμάθηση και απεικόνιση με βάση τα Windows API. Δημιουργεί στατικές απεικονίσεις χρησιμοποιώντας στατικά χαρακτηριστικά που ανακτώνται από τα αρχεία δείγματος. Lu XD et al. [25] πρότεινε μια προσέγγιση ανίχνευσης κακόβουλου κώδικα Deep Forest (MCDF). Στη διαδικασία, τα δυαδικά αρχεία μετατράπηκαν σε εικόνες κλίμακας γκρι, οι οποίες χρησιμοποιήθηκαν για εκπαίδευση και δοκιμή του μοντέλου MCDF.
Όπως αναφέρθηκε παραπάνω, οι περισσότερες μέθοδοι έρευνας χρησιμοποίησαν δομές δεδομένων μνήμης και συνδέσεις μεταξύ διαδικασιών για την εγκληματολογία μνήμης και την ανίχνευση κακόβουλου κώδικα. Είναι συχνά δύσκολο να βρείτε συγκεκριμένο κακόβουλο λογισμικό χρησιμοποιώντας αυτές τις μεθόδους. Ορισμένες προηγούμενες μεθόδους [5,12,26] ανέλυσαν συγκεκριμένα αρχεία μνήμης. Ένας άλλος προηγουμένως αναφερόμενος τρόπος [14] εξετάζει το μητρώο στη μνήμη. Μια προηγούμενη μελέτη [9] πρότεινε μια μέθοδο που μετατρέπει τα αρχεία μνήμης σε εικόνες για ανάλυση μέσω της μηχανικής μάθησης. Στις υπάρχουσες ερευνητικές μεθόδους, το σύνολο δεδομένων είναι βασικά στατικά δεδομένα ή μόνο ένα αρχείο διαδικασίας. Η κακόβουλη συμπεριφορά που εισάγεται σε άλλες διαδικασίες δεν μπορεί να ανιχνευθεί. Εξάγουμε όλες τις διαδικασίες και τα αρχεία DLL από τη μνήμη για να ανιχνεύσουμε κακόβουλο κώδικα, ειδικά τις επιθέσεις χωρίς άξια. Επιπλέον, μεγιστοποιούμε τη δημιουργία δεδομένων μνήμης PE με την εξαγωγή κακόβουλων αρχείων από τη μνήμη. Τέλος, χτίζουμε ένα μοντέλο βαθιάς μάθησης που ταιριάζει στα δεδομένα μας. Οι τυπικές τεχνικές αντι-μαλλιού βασίζονται κυρίως σε υπογραφές για να προσδιοριστούν εάν το λογισμικό περιέχει κακόβουλο κώδικα. Uroz et al. [14] ανέπτυξε το Plugin Sigcheck της μεταβλητότητας, το οποίο ανακτά τα εκτελέσιμα αρχεία από μια χωματερή μνήμης και υπολογίζει την ψηφιακή υπογραφή του (αν είναι εφικτό). Το εξέτασαν σε χωματερές μνήμης Windows 7 x86 και X64. Η μέθοδος τους απαιτεί τη λήψη του πλήρους αρχείου PE και ο ρυθμός ανίχνευσης μειώνεται και χαμηλότερα καθώς ο κώδικας τρέχει. Ωστόσο, ανιχνεύοντας θραύσματα αρχείων, η μέθοδος μας είναι πιο αποτελεσματική. Με την εκτέλεση αρκετών συνόλων πειραμάτων στο παραγόμενο σύνολο δεδομένων, καταλήγουμε στο συμπέρασμα ότι το θραύσμα δεδομένων 4096-byte στο κεφάλι του αρχείου PE στη μνήμη χρησιμοποιείται για ανίχνευση και το ποσοστό ακρίβειας είναι 97.48%.
3. Τεχνολογία εξαγωγής αρχείων μνήμης PE
3.1. Ανάλυση μνήμης
Τα ιατροδικαστικά μνήμης βασίζονται στην εικόνα μνήμης’δυαδικό αρχείο. Είναι δύσκολο να εντοπίσουμε και να αναλύσουμε τις πολύτιμες πληροφορίες από την εικόνα μνήμης που απορρίπτεται. Αν και μια διαδικασία είναι πολύ παρόμοια με ένα πρόγραμμα στην επιφάνεια, η έννοια μιας διαδικασίας είναι ουσιαστικά διαφορετική. Ένα πρόγραμμα είναι μια στατική ακολουθία οδηγιών. Η διαδικασία είναι μια δυναμική λειτουργία που περιέχει την ακολουθία εκτέλεσης και διάφορους πόρους για την εκτέλεση του προγράμματος. Στα ιατροδικαστικά μνήμης των Windows, τα αποδεικτικά στοιχεία που ελήφθησαν και η σειρά λήψης των αποδεικτικών στοιχείων για ανάλυση διαφέρουν ανάλογα με τις διαφορετικές απαιτήσεις εγκληματολογίας. Ωστόσο, προτιμάται συχνά η εκκίνηση της μελέτης με τις διεργασίες λειτουργίας επειδή το προσωπικό της εγκληματολογίας μπορεί να καταλάβει ποιες εφαρμογές εκτελούνται και τι κάνουν αυτές οι εφαρμογές μέσω της ανάλυσης της διαδικασίας.
Μέσω μιας δομής της λίστας που συνδέεται με αμφίδρομα συνδεδεμένη λίστα ActiveProcessLinks, το σύστημα των Windows μπορεί να διασχίσει όλες τις διαδικασίες που εκτελούνται στο σύστημα. Το κλειδί για την ανάλυση της επεξεργασίας είναι η απόκτηση του δείκτη στον κατάλογο των διαδικασιών συστήματος που συνδέεται με αμφίδρομη. Όπως φαίνεται στο σχήμα 1.
Ο τρόπος μετάφρασης CR3 και η λειτουργία μετάφρασης καθορίζονται σύμφωνα με τη δομή KPCR. Η σύντομη διαδικασία έχει ως εξής: Δομή KPCR -> Μέλος KPCRB -> Μέλος Επεξεργαστή -> Ειδικό Μέλος -> CR3 Μητρώο
Το PsactiveProcesshead καθορίζεται σύμφωνα με τη δομή KPCR και η διαδικασία έχει ως εξής: KPCR Δομή -> KdversionBlock -> PsactiveProcesshead;
Για να λάβετε πληροφορίες σχετικά με τις διαδικασίες, “PsactiveProcesshead” και “ActiveProcessLinks” χρησιμοποιούνται για τον εντοπισμό των διαδικασιών του συστήματος. Έτσι, μια αμφίδρομη λίστα μπορεί να διασχιστεί και όλες οι δραστηριότητες της διαδικασίας μπορούν να απαριθμηθούν.
3.2. Εγκληματολογία μνήμης
Ο αλγόριθμος χωματερής των αρχείων ΡΕ στη μνήμη εμφανίζεται στον αλγόριθμο 1. Δεδομένου ότι το αρχείο εικόνας μνήμης που πρόκειται να απορριφθεί είναι πολύ μεγάλο, πρέπει να λάβουμε την ακριβή φυσική διεύθυνση για να απορρίψουμε το απαιτούμενο αρχείο PE. Η διεύθυνση βάσης καταλόγου της σελίδας διεργασίας που λαμβάνεται στην τεχνολογία ανάλυσης μνήμης σημειώνεται ως p. Το όνομα αρχείου του αλλαγμένου αρχείου PE που είναι αποθηκευμένο στο καθορισμένο αρχείο εισάγεται στον αλγόριθμο. Ο αλγόριθμος 1 μπορεί να πετάξει τα καθορισμένα δεδομένα χώρου ΡΕ στο καθορισμένο αρχείο.
Πρώτον, εντοπίστε τον πίνακα καταλόγου σελίδων (γραμμή1) με την τιμή της διεύθυνσης βάσης καταλόγου σελίδας. Διαβάστε την καταχώρηση καταλόγου σελίδας (PDE) στον πίνακα καταλόγου σελίδας και καθορίστε εάν η καταχώρηση καταλόγου είναι κενή. Εάν η καταχώρηση του καταλόγου δεν είναι κενή, τότε σημειώστε την καταχώρηση του καταλόγου σελίδας ως Δ. Εάν το D & 1 ισούται με 1, στη συνέχεια σημειώστε την τιμή του D & 0XFFFF000 ως τη φυσική διεύθυνση του πίνακα σελίδας που καθορίζεται από την καταχώρηση του καταλόγου ως t. Εάν το D & 1 δεν ισούται με 1, προχωρήστε στην επόμενη καταχώρηση καταλόγου σελίδων μη άδειων
Δεύτερον, διαβάστε την πρώτη μη κενή καταχώρηση της σελίδας του πίνακα σελίδας. Οι καταχωρίσεις πίνακα σελίδας επισημαίνονται και εάν το T & 1 ισούται με 1, σημειώστε την τιμή του T & 0XFFFFF000 ως T ως φυσική διεύθυνση της φυσικής σελίδας που καθορίζεται από την καταχώρηση σελίδας. Εντοπίστε τη φυσική διεύθυνση στην εικόνα μνήμης, διαβάστε τα περιεχόμενα της σελίδας φυσικής μνήμης και απορρίψτε τα δεδομένα ΡΕ μιας μνήμης στο καθορισμένο αρχείο στην εικόνα μνήμης μέσω της καθορισμένης φυσικής διεύθυνσης. Ο αλγόριθμος (από τις γραμμές 2 έως 15) διασχίζει ολόκληρο τον πίνακα περιεχομένων.
Μέσω της ανάλυσης μνήμης και της τεχνολογίας απόρριψης μνήμης, μπορούμε να εξαγάγουμε το απαιτούμενο αρχείο PE μνήμης από το αρχείο εικόνας μνήμης που απορρίφθηκε για να δημιουργήσουμε το σύνολο δεδομένων μας.
Αλγόριθμος 1 Αλγόριθμος χωμάτων χώρου επεξεργασίας. 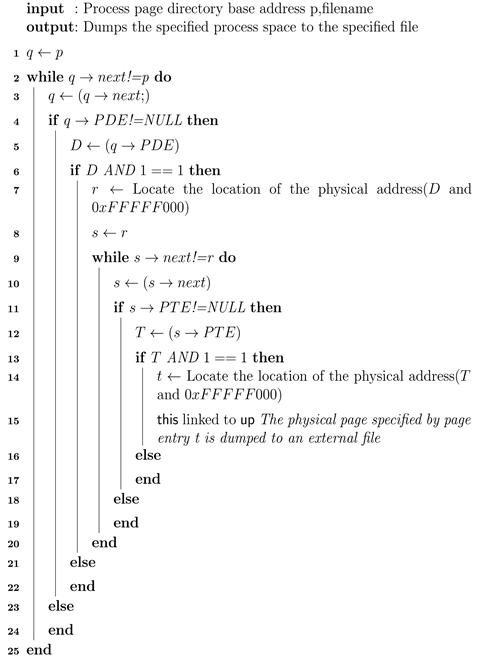
4. Η προσέγγιση
Σε αυτή την ενότητα εξηγούμε λεπτομερώς τη ροή εργασίας ολόκληρης της διαδικασίας. Η περιγραφή της ροής εργασίας απεικονίζεται στο σχήμα 2.
4.1. Συλλογή δεδομένων μνήμης
Όσον αφορά την έρευνα σχετικά με τα δυναμικά δεδομένα, ο Wei [27] χρησιμοποίησε το KDD99 για πειράματα, πολλαπλές μελέτες [28,29] χρησιμοποίησαν τη δομή του πυρήνα ως το σύνολο δεδομένων για δυναμική ανίχνευση και μια άλλη μελέτη [5] χρησιμοποίησε το δυαδικό αρχείο που εξήχθη από μία διαδικασία για να το μετατρέψει σε μια εικόνα για την ανάλυση. Τα αρχεία DLL που σχετίζονται με τη διαδικασία δεν εκμεταλλεύτηκαν ακόμα. Για να μεγιστοποιήσουμε τα κακόβουλα αρχεία στη μνήμη, εξάγουμε όλα τα αρχεία διαδικασίας και DLL από τη χωματερή μνήμη και δημιούργησαν ένα σύνολο δεδομένων.
Πρώτα απ ‘όλα, τα κοινά λογισμικά (γραφείο, βίντεο, ήχος και παιχνίδια ET.) Στο σύστημα των Windows λαμβάνονται. Στη συνέχεια εκτελούνται τα λογισμικά και τα αρχεία διαδικασίας μνήμης απορρίπτονται. Κυρίως, τα αρχεία απόρριψης μνήμης απορρίπτονται κάθε 10 λεπτά και η λειτουργία επαναλαμβάνεται δέκα φορές. Τα αρχεία PE απορρίπτονται πολλές φορές επειδή το λογισμικό δεν φορτώνει όλα τα αρχεία στη μνήμη κατά το χρόνο εκτέλεσης. Για τη συλλογή κακόβουλων δειγμάτων, τα στατικά κακόβουλα αρχεία PE μεταφέρονται από τον κακόβουλο κώδικα Virusshare και Malshare, βιβλιοθήκες που χρησιμοποιούνται ευρέως από ερευνητές [30,31] και στη συνέχεια εκτελούνται κακόβουλα δείγματα σε εικονικές μηχανές. Η μέθοδος εκχύλισης των δυναμικών κακόβουλων δειγμάτων είναι η ίδια με αυτή των καλοήθεις δείγματα. Τα κακόβουλα δείγματα απορρίπτονται σε ένα συγκεκριμένο διάστημα.
Τέλος, λαμβάνονται συνολικά 4896 δείγματα δεδομένων. Για να προσδιοριστεί εάν τα εκχυλισμένα δείγματα είναι καλοήθη ή κακόβουλα δείγματα, τα καλοήθη και κακόβουλα δείγματα επικυρώνεται μέσω της διασύνδεσης API του Virustotal.
4.2. Προεπεξεργασία δεδομένων
4.2.1. Μετατροπή τύπου δεδομένων
Το σύνολο δεδομένων του αρχείου μνήμης είναι σημαντικά διαφορετικό από το σύνολο δεδομένων κειμένου της επεξεργασίας φυσικής γλώσσας. Πρώτα προετοιμάζουμε το σύνολο δεδομένων χρησιμοποιώντας κατακερματισμό λέξεων φυσικής γλώσσας. δηλαδή, μετατρέποντας τα δυαδικά δεδομένα σε μεμονωμένες λέξεις και στη συνέχεια τη διεξαγωγή ενσωμάτωσης λέξεων. Ωστόσο, όταν το μοντέλο χρησιμοποιείται για την εκπαίδευση των επεξεργασμένων δειγμάτων, το αποτέλεσμα της εκπαίδευσης είναι κατώτερο, με ακρίβεια περίπου 0.5, η οποία δεν έχει αξία για την ταξινόμηση της διχοτόμησης. Μετά τη διεξαγωγή έρευνας, διαπιστώθηκε ότι το αρχείο Memory PE Binary έχει πολλά διαδοχικά 0 s που εμφανίζονται στο αρχείο, το οποίο δεν μπορεί να μάθει αποτελεσματικά για τα δεδομένα μετά την κατάτμηση της λέξης. Αρκετές μελέτες [9,32] μετέτρεψαν τα δυαδικά δεδομένα σε εικόνες ως σύνολα δεδομένων. Μια προηγούμενη μελέτη [14] έμαθε άμεσα τα δυαδικά αρχεία κατά τη διάρκεια της προεπεξεργασίας δεδομένων. Το σχήμα 3 δείχνει τις λειτουργίες μας στον μετασχηματισμό του τύπου δεδομένων του συνόλου δεδομένων. Το εύρος τιμής του δυαδικού αριθμού 8-bit είναι 0-255 και η τιμή της εικόνας είναι επίσης 0-255. Δεδομένου ότι τα συνελικτικά νευρωνικά δίκτυα λειτουργούν καλά στην ταξινόμηση εικόνων, μετατρέπουμε κάθε οκτώ δυαδικά κομμάτια του κακόβουλου κώδικα σε ένα δεκαδικό, καθιστώντας την παρόμοια μορφή με αριθμητικές τιμές εικόνας. Τα δεδομένα εκπαίδευσης πρέπει να μειωθούν στο ίδιο μήκος πριν προστεθούν στο μοντέλο εκπαίδευσης. Πρώτα προσθέτουμε 1 στα δεδομένα στο σύνολο δεδομένων και στη συνέχεια για δεδομένα πιο μικρά από το μήκος, το 0 χρησιμοποιείται για να συμπληρώσει τα δεδομένα για να αποφευχθεί η ανάμειξη με τα πραγματικά δεδομένα.
4.2.2. Επιλογή τμήματος
Το δείγμα δεδομένων δεδομένων λαμβάνει ένα κομμάτι του δείγματος για εκπαίδευση. Τρεις μέθοδοι υιοθετούνται για την παρακολούθηση μέρος των δεδομένων στο δείγμα.
Όπως φαίνεται στο σχήμα 4, η κεφαλίδα του δείγματος επιλέγεται για κατακερματισμό και τα μήκη της κεφαλίδας για τον κατακερματισμό είναι 32, 64, 128, 256, 512, 1024, 2048, 4096, 10.000 και 30.000 bytes. Η επίδραση της λήψης διαφορετικών μήκους των θραυσμάτων δείγματος στο μοντέλο’Η ακρίβεια παρατηρείται μέσω πειραμάτων. Επιπλέον, η μέθοδος της κατάρτισης θραύσματος δείγματος μπορεί επίσης να βελτιώσει την αποτελεσματικότητα ανίχνευσης του μοντέλου και να μειώσει σημαντικά τον χρόνο που απαιτείται για την ανίχνευση δείγματος
Όπως φαίνεται στο σχήμα 5, η ουρά του δείγματος επιλέγεται για τον κατακερματισμό έτσι ώστε η επίδραση των διαφορετικών θέσεων του θραύσματος στην ακρίβεια της εκπαίδευσης να μπορεί να κριθεί. Η ουρά επιλέγεται για να εξαγάγει το θραύσμα του δείγματος και το εκχυλισμένο μήκος είναι το ίδιο με το μήκος που εξάγεται από την κεφαλίδα, έτσι ώστε να μπορεί να εκτελεστεί καλύτερα η επίδραση των διαφορετικών θέσεων
Όπως φαίνεται στο σχήμα 6, επιλέγονται τυχαία δείγματα για τον κατακερματισμό. Για να αντικατοπτρίζουν καλύτερα την επίδραση των διαφορετικών θέσεων στα πειραματικά αποτελέσματα, δείγματα με το ίδιο μήκος θραύσματος, αλλά άλλες θέσεις εξάγονται τυχαία για κάθε δείγμα.
4.3. Το μοντέλο μας
Για την αντιμετώπιση των προβλημάτων που τα δυναμικά αρχεία PE είναι ελλιπή και είναι δύσκολη η επαγγελματική ανίχνευση του κακόβουλου λογισμικού, προτείνεται ένα βαθύ μοντέλο πλαισίου για να μάθει τα χαρακτηριστικά των δυναμικών αρχείων PE για να επιτευχθεί ο σκοπός της ταξινόμησης. Το μικροσκοπικό θραύσμα των αρχείων μνήμης (256 bytes) παρουσιάζει καλά αποτελέσματα ανίχνευσης.
Στη διαδικασία επιλογής του μοντέλου βαθιάς μάθησης, η μακρά βραχυπρόθεσμη μνήμη [33] (LSTM) χρησιμοποιείται πρώτα για τα πειράματα. Το LSTM είναι σχετικά ώριμο στον τομέα της επεξεργασίας φυσικής γλώσσας [34,35,36]. Ωστόσο, τα πειραματικά αποτελέσματα δείχνουν ότι το χρονικό κόστος της κατάρτισης μοντέλου είναι υψηλότερο από αυτό για το CNN. Λόγω των σύνθετων και ποικίλων μορφών κακόβουλου κώδικα, τα χαρακτηριστικά που εξάγονται από το CNN έχουν χαρακτηριστικά μεταφραστικής μεταφραστικής [37]. Καθώς η θέση του κακόβουλου κώδικα δεν είναι σταθερή, το CNN είναι πιο κατάλληλη για την κακή ανίχνευση κώδικα σε δυαδικά αρχεία PE. Επιπλέον, με το αυξανόμενο μήκος θραυσμάτων ακολουθίας, η ποσότητα υπολογισμού του μοντέλου LSTM θα είναι πολύ μεγάλη και η διαδικασία είναι χρονοβόρα. Παρόλο που η διάρκεια εκπαίδευσης του συνηθισμένου μοντέλου CNN είναι μικρότερη από αυτή του LSTM, η επίδραση κατάρτισης του CNN είναι παρόμοιο με αυτό του LSTM από την άποψη της ακρίβειας. Η αρχιτεκτονική μοντέλου μας έχει σχεδιαστεί για να μεγιστοποιήσει τη μάθηση από προεπεξεργασμένα δείγματα, όπως φαίνεται στο σχήμα 7. Υιοθετήσαμε ένα μοντέλο δικτύου με δομή 12 επιπέδων βασισμένη στο CNN, στην οποία χρησιμοποιήσαμε κυρίως πολλαπλά συνελικτικά στρώματα για το μοντέλο’αρχιτεκτονική. Για να αποφευχθεί η υπερφόρτωση του μοντέλου κατά τη διάρκεια της εκπαίδευσης, προσθέσαμε πολλαπλά στρώματα εγκατάλειψης. Το γενικό στρώμα εγκατάλειψης κρύβει το ένα τέταρτο των νευρώνων κόμβων. Στη μελέτη που πρότεινε τη διάσημη δομή VGG, οι Simonyan και Zisserman [21] παρατήρησαν ότι για ένα συγκεκριμένο πεδίο λήψης, η απόδοση του στοιβαγμένου μικρού συνελικτικού πυρήνα είναι καλύτερη από αυτή του μεγάλου συνελικτικού πυρήνα επειδή πολλαπλά μη γραμμικά στρώματα μπορούν να αυξήσουν το βάθος του δικτύου. Ως εκ τούτου, οι πυρήνες συνέλιξης που χρησιμοποιούνται σε αυτή τη μελέτη είναι μικροί. Για το βελτιστοποιητή στη βαθιά μάθηση, το ποσοστό ακρίβειας του Αδάμ βρέθηκε καλύτερο από αυτό του SGD. Ως εκ τούτου, υιοθετήθηκε ο Αδάμ και υιοθετήθηκε μια συνάρτηση απώλειας διασταυρούμενης εντροπίας για τη συνάρτηση απώλειας της βαθιάς μάθησης πίσω διάδοση. Το προεπεξεργασμένο σύνολο δεδομένων στην ενότητα 4.Το 2 είναι μονοδιάστατα δεδομένα, οπότε υιοθετείται το μονοδιάστατο Neural Network (CNN1D). Η διαφορά μεταξύ CNN1D και CNN είναι ότι το CNN χρησιμοποιείται κυρίως για την ανίχνευση δισδιάστατων εικόνων, ενώ το CNN1D χρησιμοποιείται για την ανίχνευση μονοδιάστατων δεδομένων. Χρησιμοποιούμε το CNN1D για να εισάγουμε μονοδιάστατα δεδομένα στο μοντέλο με λειτουργία πολλαπλών καναλιών και στη συνέχεια κάνουμε συνεχή υπολογισμό μετάφρασης από τον πυρήνα της συνέλιξης. Οι τιμές ετικέτας συγκρίνονται χρησιμοποιώντας τη λειτουργία SoftMax. Τέλος, η συνάρτηση απώλειας εντροπίας σταυροειδούς εντροπίας χρησιμοποιείται για τη διάδοση της πλάτης για τη βελτιστοποίηση του μοντέλου. Έτσι, η επίτευξη της ακριβούς ανίχνευσης της ανίχνευσης κακόβουλου κώδικα μπορεί να επιτευχθεί με υψηλή ακρίβεια. Η διαδικασία επεξεργασίας του μοντέλου LSTM είναι παρόμοια με την παραπάνω μέθοδο. Τα προεπεξεργασμένα μονοδιάστατα δεδομένα εισάγονται επίσης στο μοντέλο LSTM για την κατάρτιση και την ανίχνευση κακόβουλου κώδικα μπορεί να πραγματοποιηθεί.
4.4. Αλγόριθμος νευρικού δικτύου
Αυτή η ενότητα εισάγει τον αλγόριθμο στο μοντέλο νευρικού δικτύου που έχει σχεδιαστεί για αυτή τη μελέτη.
Τα χαρακτηριστικά εξόδου των στρωμάτων πρώτης, δεύτερης και τρίτης συνέλιξης στο περιβάλλον Pytorch μπορούν να εκφραστούν ως:
o u u t (n i, c o u t j) = b i a s (c o u t j, k) + Σ k = 0 c i n – 1 w e i g h t (c o u t j, k) × i n p u t (n i, k)
Όπου το n είναι το μέγεθος της παρτίδας, το C είναι το μέγεθος του καναλιού, το L είναι το μήκος ακολουθίας και η προκατάληψη είναι η τιμή μετατόπισης του νευρικού δικτύου. Η παρτίδα αναφέρεται στον αριθμό των δειγμάτων που υποβλήθηκαν σε επεξεργασία σε παρτίδες, καθώς τα δείγματα χωρίζονται σε διάφορες ομάδες. Ο αριθμός των δειγμάτων σε κάθε ομάδα είναι το μέγεθος της παρτίδας, i είναι ο δείκτης των ομάδων δείγματος, J είναι ο δείκτης του αριθμού των δειγμάτων και το k είναι ο δείκτης του καναλιού εισόδου.
Το μήκος της ακολουθίας εξόδου που περιλαμβάνει τα στρώματα πρώτης, δεύτερης και τρίτης συνέλιξης υπολογίζεται χρησιμοποιώντας την ακόλουθη εξίσωση:
L o u t = ⌊ l i n + 2 × p a d d i n g – d i l a t i o n (k e r e l _ s i z e – 1)
όπου lέξω είναι το μήκος ακολουθίας εξόδου, lσε είναι το μήκος της ακολουθίας εισόδου, η επένδυση είναι το μήκος πλήρωσης, η διαστολή είναι το μέγεθος της συνέλιξης της κοιλότητας, η οποία έχει οριστεί σε 1, το kernel_size είναι το μέγεθος του πυρήνα της συνέλιξης και το βήμα είναι το μέγεθος του βήματος.
Οι παραμέτρους εισόδου του επιπέδου Flatten υπολογίζονται χρησιμοποιώντας τις παραμέτρους εξόδου του στρώματος συγκέντρωσης. Η ακολουθία είναι πεπλατυσμένη χρησιμοποιώντας ένα πεπλατυσμένο στρώμα, στη συνέχεια μετατρέπεται σε δύο κόμβους νευρώνων από ένα πλήρως συνδεδεμένο στρώμα και τελικά ταξινομείται με μια λειτουργία softmax.
Το στρώμα softmax, το οποίο είναι το τελευταίο στρώμα του κρυμμένου στρώματος, δηλαδή ο ταξινομητής, εκφράζεται ως:
y k = e x p (a k) Σ i = 1 n e x p (a i)
Το exp (x) υποδηλώνει την εκθετική λειτουργία του ex (e είναι το napier’s σταθερά = 2.7182. ), το n αντιπροσωπεύει τον συνολικό αριθμό νευρώνων στο στρώμα εξόδου και yκ αντιπροσωπεύει την έξοδο των k νευρώνων στο στρώμα εξόδου, όπου ο αριθμητής είναι η εκθετική συνάρτηση του σήματος εισόδου ακ του k νευρώνα και ο παρονομαστής είναι το άθροισμα των εκθετικών λειτουργιών όλων των σημάτων εισόδου.
Η συνάρτηση απώλειας του μοντέλου νευρικού δικτύου υιοθετεί τη λειτουργία απώλειας διασταυρούμενης εντροπίας min-batch:
E = – 1 m Σ m Σ k t m k l o g y m k
Όπου το m αντιπροσωπεύει τον αριθμό των δειγμάτων σετ εκπαίδευσης, tMK αντιπροσωπεύει την τιμή του στοιχείου k του δείγματος πρόβλεψης m, yMK είναι το νευρωνικό δίκτυο’έξοδος στο δείγμα πρόβλεψης M και tMK Είναι τα εποπτευόμενα δεδομένα. Με την επέκταση της συνάρτησης απώλειας ενός μεμονωμένου στοιχείου σε κομμάτια δεδομένων και διαίρεσης με Μ στο τέλος, μπορεί να ληφθεί η μέση συνάρτηση απώλειας ενός ενιαίου θανάτου πρόβλεψης. Ένας ενοποιημένος δείκτης ανεξάρτητος από τα δεδομένα εκπαίδευσης μπορεί να ληφθεί μέσω του μέσου όρου του μέσου όρου.
Μέσω των εξισώσεων (1) και (2), μπορούμε να υπολογίσουμε κάθε συνολικό στρώμα’S μεγέθη εισόδου και εξόδου. Στο μοντέλο μας, οι παραμέτρους εισόδου του πλήρως συνδεδεμένου στρώματος πρέπει να υπολογίζονται με το χέρι όταν τα τμήματα δείγματος κατάρτισης διαφορετικών μεγεθών. Υπολογισμός κάθε στρώματος’Το μήκος S είναι περίπλοκο μέσω του παραπάνω τύπου. Παρατηρώντας και υπολογίζοντας το μοντέλο νευρωνικού δικτύου που κατασκευάσαμε, αποκτήσαμε τον τύπο για τον υπολογισμό του μήκους εισόδου του πλήρως συνδεδεμένου στρώματος στο μοντέλο μας:
(S a m p l e n – 1) m a x p o o l s i z e) – 2 m a x p o o l s i z e 2
Γελοίοςσε αντιπροσωπεύει το μήκος εισόδου του πλήρως συνδεδεμένου στρώματος, δείγμαλυγαριά αντιπροσωπεύει το μήκος του δείγματος εισόδου, το maxpoolΜέγεθος σημαίνει το μέγεθος του στρώματος συγκέντρωσης και το conv_channel αντιπροσωπεύει το μέγεθος του καναλιού εξόδου του τελευταίου στρώματος συνελαστικής. Λαμβάνοντας το μήκος του θραύσματος 2048 ως παράδειγμα, μόνο το στρώμα συνέλιξης και το στρώμα συγκέντρωσης επηρεάζουν το μέγεθος των δεδομένων και τα άλλα στρώματα νευρικού δικτύου πριν από το πλήρως συνδεδεμένο στρώμα δεν επηρεάζουν το μέγεθος των δεδομένων. Το μοντέλο μας έχει τρία στρώματα συνέλιξης και τρία στρώματα συγκέντρωσης και τα μεγέθη πυρήνα της συνέλιξης των τριών στρωμάτων συνέλιξης είναι 3, 4 και 5, αντίστοιχα. Η μέγιστη συγκέντρωση χρησιμοποιείται για το στρώμα συγκέντρωσης και τα τρία στρώματα συγκέντρωσης είναι όλα έτοιμοι σε 4. Στο μοντέλο μας, η επένδυση του στρώματος συνέλιξης έχει οριστεί σε 0, οπότε το μήκος δεδομένων θα μειωθεί κατά 1 μετά από κάθε συνέλιξη. Συρρικνώνεται με συντελεστή τεσσάρων με κάθε συγκέντρωση. Η σειρά συγκέντρωσης συνέλιξης στο μοντέλο μας είναι η συνέλιξη, η συγκέντρωση, η συνέλιξη, η συνέλιξη, η συγκέντρωση και η συγκέντρωση. Μετά τη συγκέντρωση της συνέλιξης του μοντέλου μας, το μήκος των δεδομένων με μήκος θραύσματος δείγματος 2048 μειώνεται πρώτα κατά 1 και στη συνέχεια το μήκος μειώνεται κατά τέσσερις φορές. Αφαιρώντας την έξοδο του προηγούμενου στρώματος κατά 1 δύο φορές και μειώνεται δύο φορές κατά τέσσερις φορές, το μήκος του δείγματος γίνεται 31. Τέλος, ο πολλαπλασιασμός 31 με τον αριθμό των καναλιών εξόδου του τελευταίου συνελικτικού στρώματος είναι η παράμετρος εισόδου του πλήρως συνδεδεμένου στρώματος. Το σχήμα 7 δείχνει τη λεπτομερή διαδικασία υπολογισμού του μήκους εισόδου του στρώματος ισοπέδωσης στην ενότητα Νευρωνικού δικτύου.
Οι λεπτομερείς ρυθμίσεις παραμέτρων του μοντέλου νευρικού δικτύου εισάγονται στο τμήμα 5.3.
5. Πειραματική επισκόπηση
5.1. Λειτουργικό περιβάλλον και σύνολα δεδομένων
Η CPU υλικού του πειράματός μας είναι ο επεξεργαστής Intel (R) Core (TM) I7-11800H, ο οποίος διαμορφώνεται με δύο μνήμη 8G. NVIDIA GEFORCE RTX 3050 Κάρτα γραφικών. Το περιβάλλον λογισμικού είναι ένα λειτουργικό σύστημα Windows10 64-bit και VMware, το οποίο εγκαθιστά εικονικά μηχανήματα Windows 7 και Windows XP για την εκτέλεση κακόβουλων δειγμάτων. Το περιβάλλον για την οικοδόμηση και τη λειτουργία του πλαισίου βαθιάς μάθησης είναι το Python 3.7, Anaconda Conda 4.11.0, και Pytorch Torch1.10.1. Το σύνολο δεδομένων δημιουργείται ως εξής: Συλλογή στατικών δειγμάτων από το Virusshare και το Malshare, τη λειτουργία των δειγμάτων στην εικονική μηχανή, τις πληροφορίες μνήμης απόρριψης και τις διαδικασίες εξαγωγής και τα αρχεία DLL από τα δεδομένα μνήμης.
5.2. Μετρήσεις αξιολόγησης
Για την ανίχνευση κακόβουλου κώδικα, χρησιμοποιούμε τους τέσσερις δείκτες αξιολόγησης της δυαδικής ταξινόμησης: ακρίβεια, ακρίβεια, μέτρα F και ανάκληση [38]. Το F-Measure υποδηλώνει ότι ένας δείκτης μπορεί να αντικατοπτρίζει τόσο την ακρίβεια όσο και τα ποσοστά ανάκλησης.